
AIに自社データを学習させない設定方法:企業の情報資産を守るSaaS/生成AI選び
業務効率化や新たな価値創出のために、多くの企業でAI(人工知能)を活用したSaaSツールや生成AIサービスの導入が進んでいます。しかし、その利便性の裏側には、自社の貴重な情報資産が意図せずAIの学習データとして利用されてしまうリスクが潜んでいます。特に、情報セキュリティ体制が盤石とは言えない中小企業にとって、この問題は事業の根幹を揺るがしかねない深刻な課題です。AIに自社の機密情報を安易に与えることは、情報漏洩だけでなく、企業の競争力そのものを失う危険性をはらんでいます。
本記事では、中小企業の総務・情報システム担当者の皆様に向けて、AIツールや生成AIサービスが自社の機密データを学習しないようにするための具体的な確認ポイントと設定方法を解説します。AIを安全に活用し、ビジネス成長の強力な武器とするための実践的な知識を身につけましょう。
AIに自社データを学習させてはいけない理由
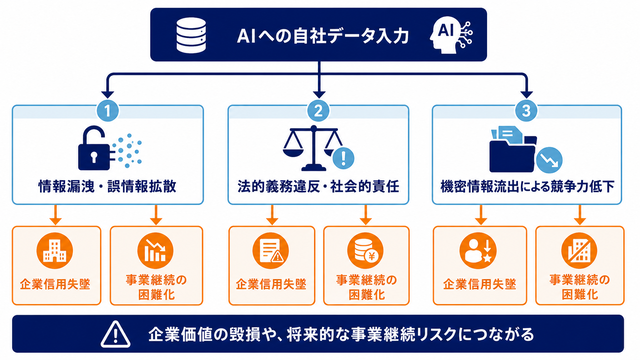
AIツールに自社の業務データを入力する行為は、意図せず企業の機密情報や顧客データをサービス提供事業者に提供してしまう可能性があり、これが情報漏洩の引き金となります。多くのAIサービスは、サービスの品質向上のためにユーザーが入力したデータを学習データとして利用する仕組みを持っています。
もし、このプロセスに機密情報が含まれていれば、それは社外に流出するリスクに直結します。特にリソースが限られる中小企業では、一度発生した情報漏洩が経営に与えるダメージは計り知れず、事業継続そのものが困難になるケースも少なくありません。そのため、AIを利用する際は、データがどのように扱われるかを正確に理解し、適切な対策を講じることが不可欠です。AIに学習させないという選択は、単なる予防策ではなく、企業の未来を守るための重要な経営判断と言えるでしょう。
意図しないデータ利用による情報漏洩・誤情報の拡散リスク
入力した業務データがAIの学習に利用される最大の危険性は、機密情報が他のユーザーへの回答として出力され、外部に流出するリスクです。
例えば、社内の新製品開発に関する企画書や、特定の顧客との取引条件といった機密情報を生成AIに入力して文章を要約させた場合、その内容がAIの知識として吸収されてしまう可能性があります。その結果、全く無関係の第三者が関連する質問をした際に、自社の機密情報の一部が回答に含まれてしまう事態が起こり得ます。
また、学習データに偏りや誤りが含まれていた場合、それが他のユーザーに対する誤った情報の生成源となり、企業の評判を損なう原因にもなりかねません。このようなリスクを回避するためには、AIにデータを入力する前に、そのデータが学習に利用されない設定になっているかを必ず確認する必要があります。
顧客・取引先データ保護の法的義務と社会的責任
企業が取り扱う顧客や取引先のデータには、個人情報保護法をはじめとする各種法令によって厳格な保護義務が課せられています。AIサービスにこれらのデータを入力し、万が一それが学習・流出してしまった場合、企業は法令違反に問われることになります。
個人情報保護法では、本人の同意なく個人データを第三者に提供することを原則として禁じており、入力データがAIモデルの学習(トレーニング)に利用される場合、この「第三者提供」に該当し本人の事前同意が必要となります。
ただし、オプトアウト設定やAPI利用により学習利用が除外されている場合は該当しないケースもあるため、契約や設定内容の確認が前提となります。法令違反が発覚すれば、行政からの是正勧告や命令、さらには罰金が科されるだけでなく、顧客や取引先からの信頼を失い、深刻な信用の失墜を招きます。
企業は法を遵守するだけでなく、預かった情報を安全に管理する社会的責任を負っていることを強く認識し、データ保護を最優先事項としてAI活用を進めなければなりません。
競争力低下につながる機密情報の流出リスク
企業の競争力の源泉である独自の技術情報、開発ノウハウ、販売戦略といった機密情報がAIの学習を通じて流出することは、事業の根幹を揺るがす致命的なリスクとなります。これらの情報は、長年の研究開発や市場分析の末に蓄積された、他社にはない独自の価値を持つものです。
もし、これらの情報がAIを介して競合他社に漏れてしまえば、模倣製品や類似サービスの出現を招き、市場における優位性を一瞬にして失うことになりかねません。
特に、独自の技術やビジネスモデルで差別化を図る中小企業にとって、機密情報の保護は生命線です。便利なAIツールであっても、その利用が自社の競争力を削ぐ結果とならないよう、入力する情報の内容を厳密に管理し、学習に利用されない仕組みを確立することが重要です。AIを導入する目的は生産性向上や競争力強化であり、その目的を損なうような事態は絶対に避けなければなりません。
データを学習させないAIツール選びの基準
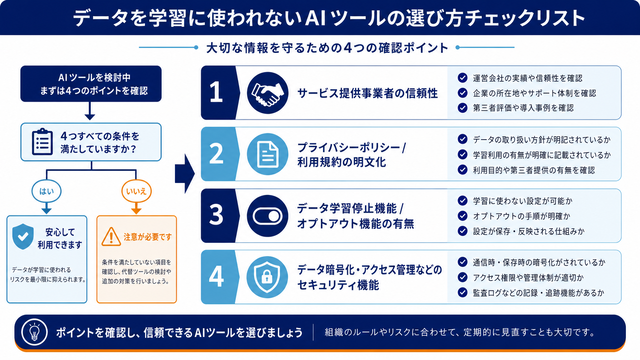
自社の情報資産をAIの意図しない学習から守るためには、導入を検討するSaaS型AIツールや生成AIサービスが、データ保護を前提とした設計になっているかを見極めることが不可欠です。具体的には、サービス提供事業者の信頼性から、利用規約の明文化、データ学習を停止する機能の有無、そしてセキュリティ機能の充実度まで、複数の視点から厳しくチェックする必要があります。これらの基準をクリアしたツールを選ぶことが、安全なAI活用の第一歩となります。単に機能の豊富さや価格だけで選ぶのではなく、情報セキュリティの観点を最優先に、自社のデータを安心して預けられるサービスかどうかを慎重に判断しましょう。
AIツール選定時のチェックリスト
| チェック項目 | 確認内容 | 重要度 | 備考 |
|---|---|---|---|
| サービス提供事業者の信頼性 | 企業の実績、セキュリティ認証(ISMS等)、過去のインシデント | 高 | 公式Webサイトや導入事例を確認 |
| プライバシーポリシー/利用規約 | データ利用方針、学習への利用有無、第三者提供の有無 | 最重要 | 曖昧な表現がないか精読 |
| データ学習停止(オプトアウト)機能 | ユーザーによる学習停止設定の有無、操作の容易さ | 高 | 初期設定がどうなっているか確認 |
| データ暗号化/アクセス管理 | 通信・保存データの暗号化、多要素認証、IP制限 | 高 | セキュリティホワイトペーパーを参照 |
| サポート体制 | 情報漏洩時の対応、問い合わせ窓口の有無 | 中 | 緊急時の連絡体制を確認 |
サービス提供事業者の信頼性と実績
AIツール選定において最も基本的な基準は、サービス提供事業者が信頼に足る企業であるかどうかです。企業の公式Webサイトで、情報セキュリティに関する基本方針やISMS(情報セキュリティマネジメントシステム)認証などの第三者認証の取得状況を確認しましょう。また、過去に重大なセキュリティインシデントを起こしていないか、導入事例としてどのような企業が名を連ねているかも重要な判断材料となります。
特に、金融機関や官公庁など、高いセキュリティレベルが求められる組織での導入実績があれば、信頼性の一つの指標と見なすことができます。企業の歴史や事業規模だけでなく、情報管理に対する姿勢や実績を多角的に評価することが、長期的に安心して利用できるツール選びにつながります。
データ利用に関するプライバシーポリシー/利用規約の明文化
プライバシーポリシーや利用規約には、ユーザーが入力したデータがどのように取り扱われるかが法的に定められており、必ず精読する必要があります。特に、「入力データをAIの学習に利用するか否か」「利用する場合、どのような形で匿名化・非識別化処理が行われるか」「データを第三者に提供する可能性があるか」といった項目が明確に記載されているかを確認してください。曖昧な表現や、企業側に有利な解釈の余地が大きい条項が含まれているサービスは避けるべきです。理想的なのは、「お客様の入力データを、本サービスの改善やAIモデルの学習に利用することはありません」と明確に断言しているサービスです。これらの文書を丁寧に読み解くことが、自社のデータを守るための重要な防衛策となります。
「データ学習停止機能」や「オプトアウト機能」の有無と設定方法
ユーザーが自らの意思でAIによるデータ学習を停止できる機能の有無は、ツール選定における重要なチェックポイントです。これは「オプトアウト機能」とも呼ばれ、ユーザーが設定画面などから簡単に学習へのデータ利用を拒否できる仕組みを指します。この機能があるかどうか、そしてその設定方法が分かりやすく、誰でも容易に操作できるかを確認しましょう。例えば、ChatGPTのように、設定画面から会話内容を学習に利用させない設定ができるサービスは、ユーザーによるデータコントロールを尊重していると言えます。反対に、オプトアウトするための手続きが煩雑であったり、そもそも機能が存在しなかったりするサービスは、情報漏洩リスクの観点から導入は慎重に検討すべきです。
データ暗号化やアクセス管理などのセキュリティ機能
入力したデータが学習に利用されない設定にしたとしても、データそのものがサービス提供者のサーバー上で安全に管理されていなければ意味がありません。そのため、通信経路や保存データの暗号化(SSL/TLS、AES-256など)、IPアドレス制限や多要素認証(MFA)といった不正アクセスを防止するためのアクセス管理機能、操作ログの記録・監視機能など、基本的なセキュリティ機能がどのレベルで実装されているかを確認することが重要です。これらの機能は、万が一のサイバー攻撃や内部不正から自社のデータを守るための最後の砦となります。サービス提供者が公表しているセキュリティに関する資料やホワイトペーパーなどを参照し、自社が求めるセキュリティ基準を満たしているかを厳しく評価しましょう。
【関連記事】不正アクセス対策の重要性|チェック方法や効果的な対策などを解説
AIのデータ学習を停止・除外する具体的な設定方法
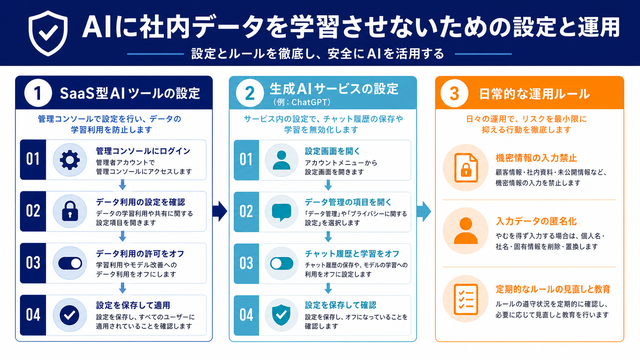
AIツールを導入した後に、自社のデータをAIに学習させないための具体的な設定を正しく行うことが、情報資産保護の鍵を握ります。多くのサービスでは、ユーザーがデータ利用の範囲をコントロールできる設定項目が用意されています。
しかし、これらの設定はデフォルトでオン(学習に利用される状態)になっている場合も少なくありません。情報システム担当者は、ツールの導入初期段階で必ずプライバシー関連の設定を確認し、自社のポリシーに合わせて変更する必要があります。ここでは、一般的なSaaS型AIツールや主要な生成AIサービスを例に、データ学習を停止するための具体的な設定手順と、日々の運用で注意すべきポイントを解説します。
SaaS型AIツールの設定画面での操作手順
多くの法人向けSaaS型AIツールでは、管理コンソールや設定画面内にデータプライバシーに関する項目が設けられています。一般的な操作手順としては、まず管理者アカウントでサービスにログインし、「設定」「アカウント管理」「セキュリティ」といったメニューを探します。その中に「データ利用」「プライバシー設定」「製品改善への協力」などの項目があれば、それを開きます。そこで「入力データをサービスの改善やモデルの学習に利用することを許可する」といった趣旨のチェックボックスがオンになっていないかを確認し、もしオンであればオフに変更します。この設定は、ユーザー個人ではなく組織全体に適用される場合が多いため、管理者が一括して設定することが重要です。導入するツールのマニュアルやヘルプページで、具体的な操作方法を事前に確認しておきましょう。
主要AIサービスにおけるデータ学習停止設定の比較
| サービス種別 | 設定項目例 | 確認・操作内容 | 注意点 |
|---|---|---|---|
| 汎用SaaS型AIツール | データ利用設定、プライバシー設定 | 管理コンソールで「学習への利用を許可しない」を選択 | 組織全体への適用範囲を確認 |
| 生成AIサービス(例: ChatGPT) | データコントロール内のモデル改善に関する設定 | 「設定」から「データコントロール」を開き、モデル改善への利用に関する項目をオフにする | 設定をオフにしても通常のチャット履歴は残る。履歴に残したくない場合は「一時チャット」を使用する |
| API経由の利用 | API利用規約 | API利用はデフォルトで学習対象外となることが多い | 利用規約で明示されているか確認 |
| オンプレミス/プライベートクラウド型AI | システム設定 | 自社環境内でデータが完結するため、学習リスクは低い | 導入・運用コストは高くなる傾向 |
生成AIサービスにおける入力データの取り扱い設定
代表的な生成AIサービスであるChatGPTでは、設定画面にあるデータ利用に関する項目から、会話内容をモデルの改善に利用するかどうかを変更できます。モデル改善への利用を停止しても、通常のチャットは履歴に残ります。履歴への保存も避けたい場合は、履歴を残さない一時的なチャット機能を利用してください。なお、設定項目の名称や画面構成は変更される場合があるため、実際に操作する際は公式ヘルプで最新情報をご確認ください。利用するプランや方法によってデータの取り扱いが異なるため、自社の利用形態に合わせた最適な設定を選択することが肝心です。
意図せずデータが学習されないための日常的な運用ルール
ツールの設定だけに頼るのではなく、従業員一人ひとりが情報セキュリティ意識を持ってAIを利用するための運用ルールを定めることが不可欠です。まず、「個人情報、顧客情報、未公開の財務情報、技術情報などの機密情報は、原則としてAIツールに入力しない」という基本ルールを徹底します。また、入力するデータは事前に匿名化・非識別化処理を施すことを推奨します。例えば、顧客名を「A社」、個人名を「山田太郎」のような仮名に置き換えるだけでもリスクは大幅に低減できます。さらに、社内で承認されたAIツール以外は業務で利用しない「シャドーIT対策」も重要です。これらのルールを社内ガイドラインとして明文化し、定期的な研修を通じて全従業員に周知徹底することで、ヒューマンエラーによる情報漏洩リスクを防ぎます。
【関連記事】情報漏洩対策の完全ガイド|企業の担当者が行うべき具体策と進め方
AIサービス利用規約とプライバシーポリシーの読み解き方
AIサービスの利用規約やプライバシーポリシーは、法律用語や専門用語が多く含まれ、読み解くのが難しいと感じるかもしれません。しかし、ここには自社のデータがどのように扱われるかという非常に重要な情報が記載されています。中小企業の情報システム担当者がこれらの文書を正確に理解し、自社の情報資産を守るためには、いくつかの重要なキーワードや条項に注目してチェックするポイントを押さえることが有効です。文書全体を隅々まで読むのが困難な場合でも、これから紹介するポイントに絞って確認するだけでも、リスクを大きく低減させることができます。
「データ利用」「学習」「匿名化」「第三者提供」に関する条項
利用規約をチェックする際は、特定のキーワードが含まれる条項に焦点を当てると効率的です。文書内の検索機能を使って以下のキーワードを探し、その周辺の記述を注意深く読んでください。
| キーワード | 確認すべきポイント |
|---|---|
| データ利用 | 入力したデータ(プロンプトや生成物を含む)が、サービスの提供目的以外(品質向上、新機能開発など)で利用されるか。 |
| 学習 (Training) | データがAIモデルの学習やトレーニングに利用されるかどうかが明記されているか。オプトアウトの可否についても確認。 |
| 匿名化 / 非識別化 | データを学習に利用する場合、個人や企業が特定できないように加工する処理が行われるか。その処理の具体性。 |
| 第三者提供 | データがサービス提供事業者以外の第三者(関連会社、提携先など)に提供される可能性があるか。その目的と範囲。 |
これらの条項で、自社が許容できない内容が含まれていないか、自社のセキュリティポリシーと整合性が取れているかを慎重に判断する必要があります。
利用規約の変更履歴と定期的な確認の重要性
AIサービスの利用規約やプライバシーポリシーは、一度確認すれば終わりではなく、頻繁に更新される可能性があることを念頭に置く必要があります。AI技術の進化や法規制の変更に対応するため、サービス提供事業者は予告なく規約を変更することがあります。多くの場合、規約の変更はメールでの通知やサービスサイト上での告知によって行われますが、見逃してしまうことも少なくありません。情報システム担当者は、主要な利用ツールの規約変更履歴ページを定期的に(例えば四半期に一度など)チェックする習慣をつけることが重要です。気づかないうちに、データ利用に関する不利な条項が追加されていた、という事態を避けるためにも、継続的な監視が求められます。
不明点があった場合の問い合わせ先と確認ポイント
利用規約を読んでも解釈が難しい、あるいは自社の状況にどう適用されるか不明な点がある場合は、決して自己判断で済ませず、サービス提供事業者に直接問い合わせることが賢明です。法人向けサービスであれば、専門の問い合わせ窓口が用意されているはずです。問い合わせる際には、漠然とした質問ではなく、具体的な条項を引用し、「当社の業務データを入力した場合、この条項に基づき、AIの学習に利用される可能性はありますか?」「『第三者』には、どの範囲の企業が含まれますか?」といったように、明確にしたい点を具体的に質問することがポイントです。書面での回答を求めることで、後日の確認資料として保存することもできます。回答内容に納得ができない場合は、法務部門や外部の専門家に相談することも検討しましょう。
社内でのAIデータ利用ポリシー策定と担当者の役割
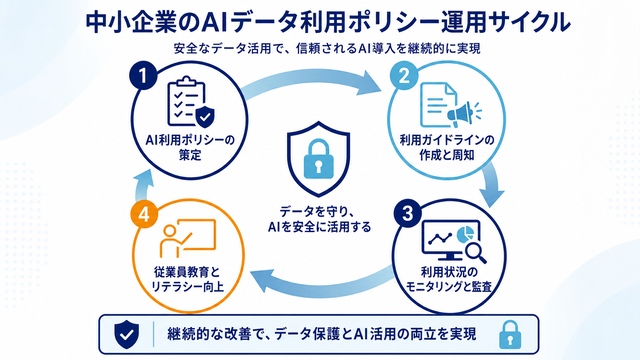
AIツールを組織として安全に活用するためには、個々の従業員の判断に任せるのではなく、会社全体で統一されたAIデータ利用ポリシーを策定し、それを遵守する体制を構築することが不可欠です。このポリシーは、AI利用の目的、許可されるツール、禁止される行為、そしてデータの取り扱い基準などを明確に定めるものでなければなりません。
情報システム担当者は、このポリシー策定の中心的な役割を担い、技術的な知見とセキュリティの観点から、実用的かつ安全なルール作りを主導する責任があります。ポリシーを策定し、それを全社に浸透させることで、組織全体のセキュリティリテラシーを高め、AI活用に伴うリスクを体系的に管理することが可能になります。
AI利用ガイドラインの作成と従業員への周知
AI利用ガイドラインは、全従業員がAIを適切かつ安全に利用するための具体的な行動指針となります。ガイドラインには、①業務利用を許可するAIサービスリスト、②機密情報や個人情報の入力禁止ルール、③生成物の著作権や正確性の確認義務、④問題発生時の報告手順などを盛り込むべきです。
作成にあたっては、平易な言葉で分かりやすく記述し、なぜそのルールが必要なのかという背景やリスクも併せて説明することで、従業員の理解を深めることができます。完成したガイドラインは、社内ポータルへの掲載や全社メールでの通達はもちろんのこと、入社時研修や定期的な勉強会で繰り返し周知し、従業員一人ひとりがその内容を正しく理解し、実践できるように働きかけることが重要です。
AI利用における情報システム担当者のチェック体制
情報システム担当者は、AIツールの選定から導入、運用、そして廃棄に至るまでのライフサイクル全体で、セキュリティチェックの役割を担います。選定段階では、本記事で解説したような基準に基づき、ツールの安全性評価を行います。導入時には、データが学習されないように初期設定を徹底し、アクセス権限を適切に管理します。
運用段階では、利用状況のログを監視し、ガイドライン違反や不審な利用がないかを定期的にチェックします。また、従業員が個人で契約してしまう「シャドーIT」を発見・防止するための仕組みも必要です。このような一貫したチェック体制を構築することで、ポリシーが形骸化するのを防ぎ、継続的なデータ保護を実現します。
定期的な教育と情報共有によるリテラシー向上
AI技術やそれを取り巻く脅威は日々進化しているため、一度ガイドラインを作成して終わりではなく、継続的な教育と情報共有が不可欠です。情報システム担当者は、最新のセキュリティ脅威やAIツールの規約変更、安全な利用方法に関する情報を収集し、定期的に従業員に共有する役割を担います。
例えば、四半期ごとにセキュリティ研修会を開催したり、情報セキュリティに関するニュースレターを配信したりする方法が考えられます。研修では、実際に起こった情報漏洩事例などを紹介することで、従業員のリスクに対する感度を高めることができます。企業全体としてAIに関するリテラシーを高め続けることが、変化の速い時代において情報資産を守り抜くための最善策となります。
【関連記事】組織を守るセキュリティ教育の実践ガイド|必要性・手法・進め方を解説
中小企業の情報資産を守るAI活用:継続的な対策と情報収集の重要性
AIを安全に活用し、その恩恵を最大限に享受するためには、一度対策を講じたら終わりではなく、継続的な情報収集と自社のデータガバナンス体制の見直しが不可欠です。AI技術は驚異的なスピードで進化しており、それに伴い、新たなリスクや法規制、そして対策手法が次々と登場します。中小企業の情報システム担当者は、常に最新の動向を把握し続ける必要があります。この継続的な取り組みこそが、急速に変化するデジタル社会において、企業の貴重な情報資産を守り、持続的な成長を支える基盤となるのです。
AI技術の進化とデータガバナンスの必要性
AIの能力が向上し、より広範な業務に活用されるようになるにつれて、取り扱われるデータの量と重要性はますます高まっていきます。これに対応するためには、企業としてデータガバナンス、すなわち「データを適切に管理し、活用するための組織的な体制やルール」を確立し、定期的に見直すことが重要です。これには、データの分類基準の明確化、アクセス権限の厳格な管理、そしてAI利用ポリシーの継続的なアップデートが含まれます。AI技術の進化に合わせて自社のデータ管理体制も進化させていくという意識を持つことが、将来にわたって安全なAI活用を続けるための鍵となります。
専門家やコンサルタントとの連携も視野に
中小企業では、情報システム担当者が他の業務と兼務しているケースも多く、AIやセキュリティに関する最新情報を常に追い続けるのは大きな負担となり得ます。自社だけでの対応に限界を感じた場合は、外部の専門家やセキュリティコンサルタントと連携することも有効な選択肢です。
専門家は、最新の技術動向や脅威情報に精通しており、客観的な視点から自社のセキュリティ体制を評価し、具体的な改善策を提案してくれます。専門家の知見を活用することで、より効率的かつ効果的にセキュリティレベルを向上させ、担当者の負担を軽減しながら、堅牢な情報保護体制を構築することが可能になります。
安全なAI活用で企業の生産性向上と競争力強化へ
AIに自社データを学習させないための対策は、単なるリスク回避のための守りの一手ではありません。むしろ、情報資産を安全に保護する基盤を固めることで、企業は安心してAIを業務に活用し、そのメリットを最大限に引き出すことができるようになります。
適切な対策を講じることで、従業員は情報漏洩の心配をすることなく、AIを使って定型業務を自動化したり、データ分析から新たなインサイトを得たりと、より創造的で付加価値の高い業務に集中できます。
結果として、企業全体の生産性が向上し、新たなビジネスチャンスの創出にもつながります。安全なAI活用は、中小企業が厳しい市場競争を勝ち抜き、持続的に成長していくための強力な推進力となるのです。
まとめ:安全な基盤でAIを戦略的に活用するために
本記事では、中小企業がAIツールや生成AIサービスを利用する際に、自社の機密情報や顧客データをAIの学習から守るための具体的な方法について解説しました。AIがもたらす業務効率化の恩恵は計り知れませんが、その裏側にある情報漏洩のリスクを正しく理解し、適切な対策を講じなければ、企業の存続を脅かす事態にもなりかねません。
AIにデータを学習させないためには、まずツール選定の段階で、提供事業者の信頼性や利用規約の内容、オプトアウト機能の有無を厳しくチェックすることが重要です。導入後は、ChatGPTなどのサービスが提供する設定機能を活用し、データが学習に利用されないように設定します。さらに、ツール側の設定だけに頼るのではなく、社内にAI利用ガイドラインを策定し、従業員への教育を徹底することで、組織全体で情報資産を守る文化を醸成することが不可欠です。AIの進化は今後も加速していきます。継続的な情報収集と対策の見直しを行い、安全な基盤の上でAIを戦略的に活用し、企業の生産性向上と競争力強化につなげていきましょう。