
企業向けRAGシステム構築の成功戦略:事業価値最大化へのロードマップ
2026年現在、生成AI、特に大規模言語モデル(LLM)のビジネス活用が急速に進む中、多くの企業がその潜在能力に注目しています。しかし、LLMが持つ「ハルシネーション(幻覚)」や「学習データ外の知識に対応できない」といった課題は、特に正確性と信頼性が求められるビジネスシーンでの本格導入を阻む大きな壁となっていました。この課題を解決する技術として、RAG(Retrieval-Augmented Generation)が脚光を浴びています。
本記事では、企業の新規事業開発部門に所属するプロダクトマネージャーを対象に、RAGシステム構築プロジェクトの全体像から、計画、技術的課題、成功のポイント、そして事業価値を最大化するための戦略までを網羅的に解説します。社内の独自データを活用し、競争優位性の高い新規事業やサービスを創出するためのロードマップとしてご活用ください。
RAG導入で新規事業を加速させる戦略的価値とプロジェクトの全体像
RAGシステムの導入は、企業の知識資産を最大限に活用し、新たな事業価値を創出するための戦略的投資です。その核心は、LLMの汎用的な能力と、企業が持つ独自の専門的かつ最新の情報を組み合わせる点にあります。このセクションでは、RAGがもたらすビジネス上の価値と、その実現に向けたプロジェクトの全体像を明らかにします。
大規模言語モデルの限界を克服するRAGのビジネスインパクト
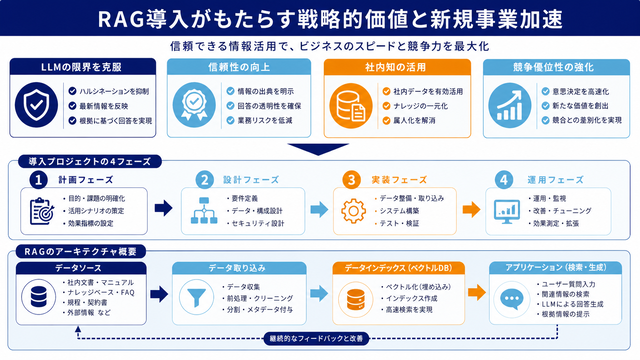
RAGは、大規模言語モデル(LLM)が持つ根本的な課題を克服し、ビジネス利用における信頼性と精度を飛躍的に向上させる技術です。LLMは、その学習データに含まれない最新の情報や、社内固有の専門知識には対応できず、事実に基づかない情報を生成する「ハルシネーション」のリスクを常に抱えています。RAGは、ユーザーからの質問に対し、まず社内文書やデータベースといった信頼できる情報源から関連性の高い情報を検索(Retrieval)し、その情報を根拠としてLLMに回答を生成(Generation)させる仕組みです。LLMのRAG構築とは、この検索と生成を組み合わせるプロセスを指します。これにより、回答の根拠が明確になり、情報の正確性と鮮度が担保されるため、顧客サポートの自動応答や専門的な社内ナレッジ検索など、高い信頼性が求められる業務への応用が可能になります。
RAGシステム構築プロジェクトの主要フェーズと役割分担
RAGシステムの構築プロジェクトは、一般的に「企画」「設計」「実装」「運用」という4つの主要フェーズで進行します。各フェーズでは、多様な専門性を持つ人材が連携してプロジェクトを推進します。企画フェーズでは、プロダクトマネージャーが中心となり、ビジネス課題の特定、目標設定、ROI(投資対効果)の試算を行います。設計フェーズでは、ITアーキテクトやデータサイエンティストが、既存システムとの連携を考慮したシステム全体の構成や使用する技術要素を決定します。実装フェーズでは、AI/MLエンジニアやバックエンドエンジニアが、データの取り込みパイプライン、ベクトルデータベースの構築、API開発などを担当します。そして運用フェーズでは、MLOpsエンジニアがシステムの安定稼働、パフォーマンス監視、継続的な精度改善を担います。プロダクトマネージャーは、これらすべてのフェーズを通じて、各担当者の連携を促し、プロジェクト全体の進捗を管理する重要な役割を担います。
既存システムとの連携を前提としたRAGアーキテクチャ概要
RAGシステムの基本的なアーキテクチャは、「データソース」「データインジェスチョン(取り込み)」「データインデックス(検索基盤)」「アプリケーション」の4層で構成されます。企業におけるRAGシステム構築では、これらの層が既存の膨大なデータ資産や業務システムと連携することが成功の鍵を握ります。データソースは、社内のファイルサーバー、データベース、CRM、ERPなど多岐にわたります。データインジェスチョン層では、これらの多様な形式のデータを抽出し、テキスト化、分割(チャンキング)、そしてベクトル化(Embedding)して、検索に適した形式に変換します。データインデックス層の中心となるのがベクトルデータベースで、ここでベクトル化されたデータが格納され、高速な類似度検索が可能になります。最後のアプリケーション層では、ユーザーからの入力を受け付け、ベクトルデータベースで検索した情報を基にLLMが回答を生成し、ユーザーインターフェースを通じて提供します。このアーキテクチャ選定においては、将来的なデータ量の増加や利用者の拡大を見越したスケーラビリティと、企業のセキュリティポリシーを遵守するガバナンスの確保が極めて重要です。
RAGプロジェクト計画:期間・コスト・必要なリソースの見極め方
RAGプロジェクトの計画では、期間、コスト、人材という3つの主要リソースを正確に見積もることが、成功の基盤となります。実現可能性の高いプロジェクト計画を策定することは、経営層の承認を得て予算を確保する上で重要なステップです。ここでは、具体的な計画策定に役立つ指標や考え方を解説します。
RAG構築フェーズごとの標準的な期間とマイルストーン
RAGシステム構築のプロジェクト期間は、PoC(概念実証)フェーズに1〜3ヶ月、本格的な開発から初期リリースまでに6ヶ月〜1年程度を見込むのが一般的です。ただし、この期間は要件や対象データの規模によって大きく変動します。プロジェクト管理を効果的に行うためには、フェーズごとに明確なマイルストーンを設定することが重要です。例えば、PoCフェーズでは「特定ドメインのデータでの回答精度検証完了」、開発フェーズでは「プロトタイプUI完成」「主要なデータソースとの連携完了」「セキュリティ要件充足テスト合格」などがマイルストーンとなり得ます。これらのマイルストーンを達成するごとにステークホルダーへ進捗を報告し、フィードバックを得ることで、手戻りを防ぎ、プロジェクトを円滑に推進できます。
関連部署との調整に時間を要する場合があるため、スケジュールには余裕を持たせることが賢明です。
開発・運用コストを最適化する見積もりと予算策定の要点
RAGシステムのコストは、大きく「初期開発コスト」と「運用・保守コスト」に分類されます。初期開発コストには、プロジェクトに関わるエンジニアやプロダクトマネージャーの人件費、商用ツールを利用する場合のライセンス費用が含まれます。一方、運用・保守コストには、LLMのAPI利用料(トークン数に応じた従量課金)、ベクトルデータベースやアプリケーションサーバーなどのクラウドインフラ費用、そしてシステムの監視やデータ更新を行うための人件費が計上されます。予算策定の勘所は、スモールスタートでPoCを行い、その結果を基にROIを試算して段階的に投資を拡大していくことです。例えば、特定の部署の問い合わせ対応業務を対象に効果を測定し、年間数千万円のコスト削減効果が見込める、といった具体的な数値を提示することで、経営層の理解と承認を得やすくなります。
専門人材(プロンプトエンジニア、MLOpsエンジニア等)の確保と育成戦略
RAGシステムの成功には、専門人材を確保するため、外部からの採用と並行して、社内での育成戦略を推進することが重要です。RAGシステムの構築と運用には、従来のシステム開発とは異なる専門スキルを持つ人材が不可欠です。特に、LLMの性能を最大限に引き出す質問文(プロンプト)を設計する「プロンプトエンジニア」、AI/MLモデルのライフサイクル全体を管理し、安定的な運用を実現する「MLOpsエンジニア」、そしてデータの前処理やベクトル化を担当する「データサイエンティスト」は中核となる存在です。例えば、既存のソフトウェアエンジニアを対象に、Pythonを用いたRAG構築入門トレーニングや、クラウドベンダーが提供するAI関連の認定資格取得を支援するプログラムを設けることが有効です。社内勉強会などを通じて知識を共有し、組織全体のAIリテラシーを向上させる取り組みも、長期的な成功につながります。
オープンソース vs. 商用ツール:効果的なリソース投資の選択基準
RAG構築に用いるツールの選択は、コスト、開発速度、カスタマイズの自由度、そして自社の技術力を総合的に勘案して決定すべきです。ツールにはオープンソースソフトウェア(OSS)と、クラウドベンダーなどが提供する商用ソリューションがあります。OSS(例:LangChain, LlamaIndex)を活用する場合、ライセンス費用がかからず、RAG構築を無料(インフラ費用等は除く)で始められる上、柔軟なカスタマイズが可能です。一方で、自社で環境構築やメンテナンスを行う必要があり、高度な技術力が求められます。特にセキュリティ要件の厳しい企業では、プライベートクラウドやオンプレミス環境で「RAG構築 ローカル」を実現する際にOSSが選択されることがあります。対照的に、Azure AI SearchやAmazon Bedrockといった商用ツールは、インフラ管理の手間が少なく、短期間で高品質なシステムを構築できるメリットがありますが、利用料が発生します。初期段階では開発速度を重視して商用ツールでPoCを行い、本格展開の際にコストと要件に応じてOSSへの移行を検討する、といったハイブリッドなアプローチも有効な戦略です。
RAG構築ツール比較:オープンソース vs. 商用ソリューション
| 項目 | オープンソース (OSS) | 商用ソリューション |
|---|---|---|
| 初期費用 | ライセンス無料(インフラ費用は別途) | ライセンス費用が発生 |
| 運用コスト | 自社でのメンテナンス費用 | API利用料、サブスクリプション費用 |
| 開発速度 | 環境構築・設定に時間を要する | 短期間での構築が可能 |
| カスタマイズ性 | 非常に高い(ソースコード変更可) | 提供範囲内で限定的 |
| 技術的専門性 | 高度な知識とスキルが必要 | 比較的容易に導入・運用可能 |
| サポート・保守 | コミュニティベース | ベンダーによる専門サポート |
| 主な利用シーン | 高度な要件、コスト重視、プライベート環境 | PoC、迅速な導入、運用負荷軽減 |
RAG構築における主要な技術的課題と戦略的解決策
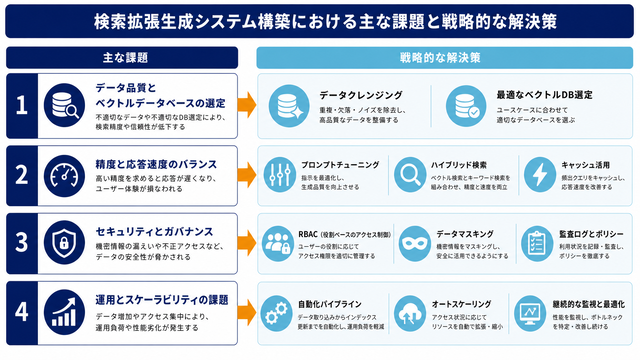
RAG構築における主要な技術的課題は、データ品質、検索性能、セキュリティの3点であり、それぞれに戦略的な解決策が求められます。そのポテンシャルの高さゆえに、RAGプロジェクトは多くの技術的な挑戦を伴います。特に、回答精度の根幹をなす要素、大量のデータから最適な情報を高速に検索する技術、そして企業の信頼を左右するガバナンスの確保は、プロジェクトの成否を分ける重要な要素です。このセクションでは、実装フェーズで直面しがちな課題と、それらを乗り越えるための戦略的な解決策を解説します。
データ品質とベクトルデータベース選定の重要性
RAGプロジェクトの成功には、初期段階で、取り込むデータの品質を確保するためのプロセスを確立することが最も重要です。システムの回答精度は、参照するデータの品質に直接的に依存するためです。具体的には、古くなった情報や誤った記述を含むドキュメントを事前にクレンジングし、定期的に情報を最新化するワークフローを構築する必要があります。また、検索精度を左右するベクトルデータベースの選定も重要な意思決定です。選定にあたっては、データ規模や求められる検索速度、クラウド環境かオンプレミス環境かといった運用要件を考慮します。代表的なベクトルデータベースには、マネージドサービスであるPineconeや、オープンソースのMilvus、Chromaなどがあり、それぞれの特性を理解し、PoCを通じて自社のユースケースに最適なものを選定するアプローチが推奨されます。
RAG構築における主要技術課題と戦略的解決策
| 主要技術課題 | 具体的な問題点 | 戦略的解決策 |
|---|---|---|
| データ品質 | 不正確・古い情報、多様なデータ形式、ノイズ | データクレンジング、定期的な更新パイプライン |
| 検索性能 | 関連性の低い情報、検索速度、大規模データ対応 | 適切なベクトルデータベース選定、エンベディングモデルの最適化、ハイブリッド検索導入、チャンキング最適化 |
| セキュリティ・ガバナンス | 機密情報漏洩、アクセス制御、コンプライアンス遵守 | 厳格なアクセス権管理、データ暗号化、監査ログ、プライベート環境での構築 |
精度向上と応答速度を両立させるプロンプトチューニングと検索アルゴリズム
RAGシステムの精度向上の鍵を握るのが、データの分割方法(チャンキング)とプロンプトの設計です。性能を最大化するためには、検索の精度と応答速度のバランスを取るための技術的な工夫が求められます。ドキュメントをどのような単位で分割してベクトル化するかは、検索結果の質に大きく影響します。意味のあるまとまりで分割する、あるいは重複部分を持たせて分割する(オーバーラップチャンキング)などの手法を試し、最適な戦略を見つける必要があります。また、LLMに与えるプロンプトを工夫することで、検索結果をより効果的に要約させ、ユーザーの意図に沿った回答を生成させることができます。一方、応答速度を確保するためには、効率的な検索アルゴリズムの採用が不可欠です。単純な類似度検索だけでなく、質問から仮の回答文書を生成し、その文書をベクトル化して検索するHyDE(Hypothetical Document Embeddings)のような高度な手法も、検索精度の向上に貢献します。
進化するRAG:2026年最新技術トレンドとスタック
2026年現在のRAG技術は、単純なベクトル検索から、より高度で複合的な検索アプローチへと進化しています。最新の動向を把握し、適切な技術スタックを選択することが競争優位につながります。精度向上の主流となっているのが、ベクトル検索と従来のキーワード検索(BM25など)を組み合わせる「ハイブリッド検索」です。これにより、意味の類似性とキーワードの一致の両面から検索が可能になります。さらに、検索結果をより文脈に適した順序に並べ替える「リランキング」モデルの活用や、LLM自身がユーザーの曖昧な質問を複数の具体的な検索クエリに変換する「クエリ変換」といった技術も一般化しつつあります。技術スタックでは、LangChainやLlamaIndexといったフレームワークがエコシステムを拡大し、これらの高度な検索手法を容易に実装できるようになっています。また、複数の情報源を自律的に参照・思考して複雑なタスクを実行する「エージェント」技術もRAGの応用範囲を広げるトレンドとして注目されています。
セキュリティとガバナンスを確保するデータプライバシー対策
企業のRAGシステムでは、役職や所属部署に応じてアクセスできる情報を制御する、ロールベースのアクセス制御(RBAC)の実装が不可欠です。社内データを扱う上で、セキュリティとガバナンスの確保は絶対条件となります。例えば、人事評価に関するドキュメントは人事部の管理職しか参照できないように、検索対象となるデータソースのアクセス権限をRAGシステム上でも厳密に反映させる必要があります。また、個人情報や機密情報がプロンプトに含まれたり、LLMの回答として生成されたりしないよう、データのマスキングやフィルタリング処理を組み込むことも重要です。すべてのユーザー操作やシステム動作のログを記録し、定期的に監査を行う体制を整えることで、万が一のインシデント発生時にも迅速な原因究明と対応が可能となり、企業のコンプライアンス要件を満たすことができます。
導入後の運用課題とスケーラビリティ対策
RAGシステムを本番導入した後は、データ鮮度の維持、精度劣化への対応、コスト管理といった運用課題に直面します。これらの課題への対策を事前に計画することが安定稼働の鍵です。具体的には、ドキュメントの追加・更新を自動でシステムに反映させるデータパイプラインの構築や、ユーザーの検索傾向の変化による精度劣化(ドリフト)を検知するための定期的な評価、そして参照情報と乖離した回答(ハルシネーション)を監視する仕組みが求められます。また、利用量に応じて変動するLLMのAPI利用料やインフラコストを最適化するための監視・アラート体制も重要です。これらの運用課題に加え、将来の利用拡大を見越したスケーラビリティ対策も欠かせません。マイクロサービスアーキテクチャの採用や、負荷に応じてリソースを自動増減させるオートスケーリング設定などが有効です。
成功に導くRAGシステム設計と実装のポイント
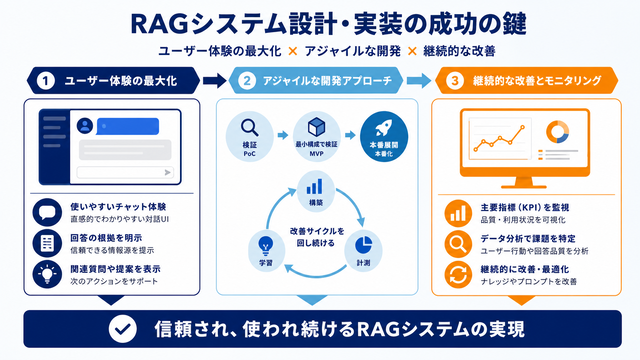
技術的な課題を乗り越え、実際に価値を生み出すRAGシステムを構築するためには、ユーザー視点に立った設計と、変化に迅速に対応できる開発プロセスが求められます。プロダクトマネージャーは、技術的な側面だけでなく、最終的なユーザー体験(UX)の向上や、プロジェクトのリスク管理にも目を配る必要があります。このセクションでは、RAGシステムを成功に導くための設計と実装における重要なポイントを解説します。
ユーザー体験を最大化するUI/UX設計とインターフェース戦略
RAGシステムを成功させるには、ユーザーがストレスなく、直感的に情報を引き出せるインターフェースを提供することも重要です。システムが持つ高度な機能をユーザーが最大限に活用できるかどうかは、優れたUI/UX設計にかかっています。多くのRAGシステムでは、自然な対話が可能なチャット形式のインターフェースが採用されます。その際、単に回答を表示するだけでなく、回答の根拠となった社内ドキュメントへのリンクを併記することで、ユーザーは情報の信頼性を自ら確認でき、より深い理解を得ることができます。また、「この質問に関連する他の情報はこちらです」といったサジェスト機能や、複雑な問い合わせを簡単に行うための入力テンプレートを用意することも、ユーザー体験の向上に大きく貢献します。社内RAG構築の目的が業務効率化である以上、使いやすさは機能と同等、あるいはそれ以上に重要な要素となります。
プロトタイプ開発から本番運用までのアジャイルなアプローチ
要件が不確実で、技術的な挑戦も多いRAGシステムの開発プロジェクトでは、ウォーターフォール型のような従来の開発手法よりも、アジャイルなアプローチが適しています。リスクを最小限に抑えつつ、迅速に価値を届けるためには、早期に動作するプロトタイプを開発し、実際のユーザーからのフィードバックを得ながら段階的に機能を改善していくことが効果的です。まず、対象業務やデータを限定した小規模なPoC(概念実証)から始め、RAG技術の有効性を検証します。次に、主要な機能を実装したMVP(Minimum Viable Product)を開発し、一部のユーザーに先行して利用してもらうことで、実用上の課題を洗い出します。この「構築→計測→学習」のサイクルを短期間で繰り返すことにより、ユーザーの真のニーズに合致したシステムへと進化させることが可能となり、大規模な手戻りやプロジェクトの失敗リスクを大幅に低減できます。
パフォーマンス監視と継続的な改善サイクル
RAGシステムの価値を長期的に維持・向上させるためには、システムのパフォーマンスを定量的に評価し、改善につなげるためのサイクルを確立することが不可欠です。システムの価値は、一度構築して終わりではなく、運用を通じて継続的に向上させていくものだからです。監視すべき主要な指標(KPI)には、「回答の正解率」「ユーザー満足度評価(Good/Bad評価など)」「検索結果がユーザーの意図と合致した割合(適合率)」「情報検索にかかる時間の短縮率」などがあります。これらのデータを定期的に収集・分析し、パフォーマンスが低下している原因を特定します。例えば、特定の種類の質問に対する正解率が低い場合は、関連データの追加や前処理方法の見直し、プロンプトの改善といった対策を講じます。このようなデータ駆動型のアプローチによって、RAGシステムはビジネス環境の変化に対応し、長期的に高い価値を提供し続けることができます。
企業におけるRAG活用事例とROI最大化のヒント
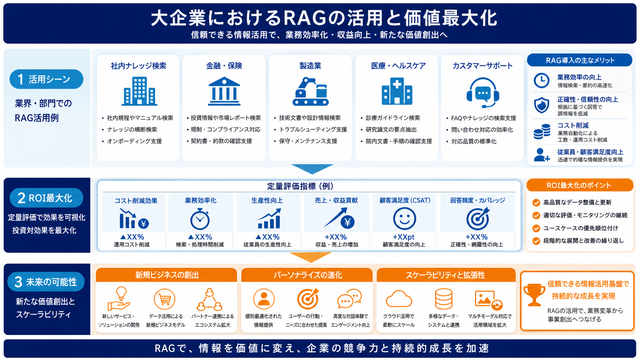
RAGシステムは、社内ナレッジ検索や顧客サポートといった業務で具体的な成果を上げており、その投資対効果(ROI)を最大化するには定量的な効果測定が不可欠です。社内に散在する膨大な知識資産を有効活用することで、業務効率の向上、顧客満足度の向上、そして新たな事業機会の創出につながっています。このセクションでは、実際の活用事例を参考に、RAG導入のROIを最大化するための戦略的ヒントを探ります。
【業界・部門別】RAG導入の成功事例とユースケース
RAGの活用は多岐にわたる業界・部門で効果を発揮しており、最も代表的な成功事例は、全社横断的な社内ナレッジ検索システムの構築です。社内規程、業務マニュアル、過去のプロジェクト報告書など、散在する情報を一元的に検索可能にすることで、従業員の生産性を向上させます。これを応用し、特定の業界ニーズに合わせたユースケースも拡大しています。
金融業界では、膨大な市場レポートや法規制文書を分析し、コンプライアンスチェックの自動化や投資判断の支援に活用されています。製造業では、過去の故障事例や技術仕様書を検索対象とし、熟練技術者のノウハウを形式知化して現場でのトラブルシューティングを迅速化します。また、医療・製薬業界では最新の学術論文や治験データをRAGで分析し、研究開発の迅速化に貢献しています。顧客サポート部門では、FAQやマニュアルを基にチャットボットが24時間対応することで、顧客満足度の向上とオペレーターの負荷軽減を両立しています。
参照:LINEヤフー、RAG技術を活用した独自業務効率化ツール「SeekAI」を全従業員に本格導入。膨大な社内文書データベースから部門ごとに最適な回答を表示し、確認・問い合わせ時間を大幅に削減
投資対効果(ROI)を定量的に評価する指標と計測方法
RAG導入のROIを評価するためのKPI(重要業績評価指標)としては、「業務効率化によるコスト削減額」や「顧客満足度向上による売上増加額」などが挙げられます。プロジェクトへの継続的な投資を確保するためには、その効果を定量的、つまり金額換算で示すことが重要です。例えば、社内ナレッジ検索システムの導入効果を測定する場合、「従業員が1日あたり情報検索に費やす時間」を導入前後で比較し、短縮された時間に平均時給を掛けることで、人件費削減効果を算出できます。顧客サポートの文脈では、オペレーター一人あたりの対応件数の増加や、顧客満足度スコア(CSAT)の向上、解約率の低下などを計測し、それらがもたらす経済的価値を評価します。これらのKPIをプロジェクト開始前に設定し、定期的に効果測定を行うことで、RAG導入の事業貢献度を客観的に示すことが可能になります。
新規事業創出につながるRAGの未来と拡張性
RAG技術は、企業の独自データとLLMの能力を組み合わせることで、これまで不可能だった新たなサービスや事業を創出する強力な基盤となり得ます。その応用範囲は、既存業務の効率化に留まりません。例えば、金融機関が膨大な市場データや経済レポートをRAGシステムで分析し、個々の顧客にパーソナライズされた投資アドバイスを提供するサービスを開発するケースが考えられます。また、製造業では、熟練技術者のノウハウや過去のトラブルシューティング事例をデータ化し、若手技術者のスキル習得を支援する教育プラットフォームや、現場での迅速な問題解決を支援するツールへと展開できます。将来的には、テキストデータだけでなく、画像や音声といったマルチモーダルな情報も統合的に扱えるようになると予測されており、システムの設計段階からこのような技術の進化を見越した拡張性の高いアーキテクチャを採用しておくことが、持続的な競争優位性を築く上で重要です。
RAGプロジェクトを成功させるための体制構築とパートナー選定
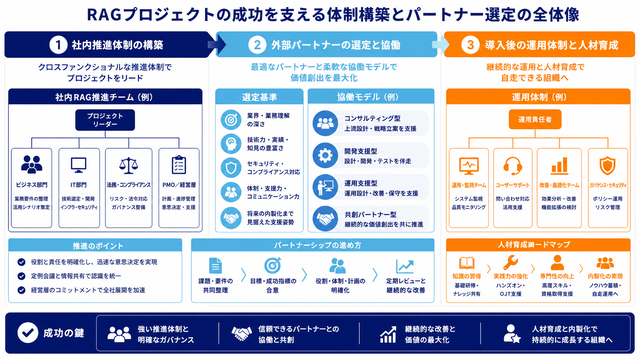
RAGプロジェクトを成功させるには、社内横断型の推進チームを組成し、必要に応じて外部の専門パートナーと効果的に連携する体制構築が不可欠です。優れた技術や緻密な計画があったとしても、それを実行する「組織」が伴わなければプロジェクトを成功に導くことは困難です。特に、部門間の連携が複雑になりがちな企業においては、全社的な協力体制と外部の専門知識の活用が成功の鍵となります。
社内横断型RAG推進チームの組成とリーダーシップ
RAGプロジェクトを成功させるためには、関連部署からキーパーソンを集めた社内横断型の推進チームを組成することが重要です。このプロジェクトは、単一の部署だけで完結するものではなく、事業部門、IT部門、法務・コンプライアンス部門など、社内のさまざまなステークホルダーを巻き込む必要があります。事業部門はビジネス要件を定義し、IT部門はシステム開発とインフラ構築を担い、法務部門はデータ利用に関するコンプライアンスをチェックします。プロダクトマネージャーは、このチームの中核的な役割を担い、各部署の要求を調整しながら、プロジェクト全体のビジョンを明確に示し、チームを牽引するリーダーシップを発揮する必要があります。定期的な進捗共有会議やワークショップを開催し、オープンなコミュニケーションを促進することで、組織の壁を越えた協力関係を築き、プロジェクトを円滑に進めることができます。
外部ベンダー・コンサルティング会社との効果的な連携戦略
外部パートナーを選定する際の基準は、単なる技術力の高さだけでなく、自社のビジネスや業界に対する深い理解度、そして過去のRAG構築における実績です。RAGシステムの構築には、LLM、ベクトルデータベース、MLOpsなど、最先端かつ多岐にわたる専門知識が要求されるため、自社内に知見が不足している場合は外部との連携が非常に有効な戦略となります。契約形態としては、システム開発全体を委託するだけでなく、技術的なアドバイザリーとして専門家をチームに迎え入れたり、特定の技術課題の解決に特化した支援を依頼したりするなど、自社の状況に合わせて柔軟に検討します。プロジェクトを円滑に進めるためには、外部パートナーを単なる「発注先」として扱うのではなく、自社のチームメンバーの一員として迎え入れ、密な情報共有と対等な議論ができる関係性を築くことが成功の鍵となります。
RAG導入後の運用体制と人材育成ロードマップ
RAGシステムの価値を最大化するには、システムをリリースする前に、安定稼働を支える運用体制と、将来的に内製化を進めるための人材育成計画を明確に定めておく必要があります。運用体制には、システムの監視、障害発生時の対応、定期的なデータ更新、ユーザーからの問い合わせ対応などが含まれます。当初は開発を委託した外部ベンダーに運用・保守を依頼することも一案ですが、長期的にはコスト削減とノウハウ蓄積の観点から、社内での運用を目指すべきです。そのためには、OJT(On-the-Job Training)を通じてベンダーから知識移転を進めると同時に、社内エンジニア向けの研修プログラムや資格取得支援制度を整備し、計画的にAI/ML人材を育成していくロードマップを描くことが重要です。
まとめ:RAGの構築プロジェクトの鍵は体制の構築
本記事では、企業がRAGシステムを構築し、事業価値を最大化するための戦略的なロードマップを解説しました。RAGは、LLMの限界を克服し、企業独自のデータを活用して信頼性の高いAIアプリケーションを実現する革新的な技術です。その導入は、単なる業務効率化に留まらず、新たな顧客体験の創出や、データ駆動型の新規事業開発を加速させる大きな可能性を秘めています。
RAG構築プロジェクトを成功に導くためには、明確なビジネス目標の設定、緻密な計画、そしてそれを実行するための強力な推進体制が不可欠です。プロダクトマネージャーは、技術的な課題解決だけでなく、社内横断での合意形成、予算確保、そしてユーザー体験の最大化といった多岐にわたる役割を担います。本記事で紹介した各フェーズのポイントや戦略を参考に、貴社の競争優位性の確立に向け、RAGシステム構築を推進することをおすすめします。