
RAGとは?生成AIのビジネス活用を加速させる基本概念
現在、多くの企業でデジタルトランスフォーメーション(DX)が進む中、生成AIの活用は業務効率化や新たな価値創出の鍵として期待されています。しかし、その一方で、生成AIが時として不正確な情報を生成する「ハルシネーション」や、学習データに含まれない最新情報・社内情報に対応できないといった課題も浮き彫りになってきました。
このような課題を解決し、生成AIのビジネス活用をさらに高度化する技術が「RAG(ラグ)」です。本記事では、DX推進を担う企画担当者の皆様に向けて、RAGの基本的な概念からその仕組み、導入によるメリット、そして具体的な活用シーンまで、ビジネス活用の全体像を分かりやすく解説します。この記事を読めば、自社における生成AI活用の次の施策を検討する際の手がかりが得られます。
RAG(検索拡張生成)とは?DX企画担当者が理解すべき基本概念
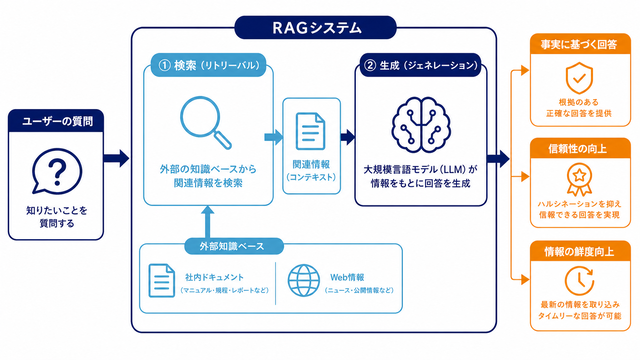
RAG(Retrieval-Augmented Generation)とは、生成AIの回答精度と信頼性を向上させるために、外部の知識ベースから関連情報を検索し、その情報を基に回答を生成する技術です。日本語では「検索拡張生成」と訳され、その読み方は一般的に「ラグ」またはアルファベットのまま「アールエージー」と呼ばれます。この技術は、大規模言語モデル(LLM)が持つ生成能力と、検索システムが持つ情報特定能力を組み合わせることで、生成AIの性能を最大限に引き出します。
従来の生成方法では、事前に学習した膨大なデータの中にある知識だけで回答を生成していました。しかし、RAGを導入することで、AIは回答を生成する都度、社内文書データベースや最新のWeb情報といった特定の情報源を参照できるようになります。
これにより、AIは常に最新で、かつ根拠の明確な情報に基づいた回答を生成することが可能となり、ビジネスシーンにおける生成AI活用の信頼性を飛躍的に高める技術として、現在、注目を集めています。
なぜRAGが必要なのか?生成AIが抱える課題と解決策
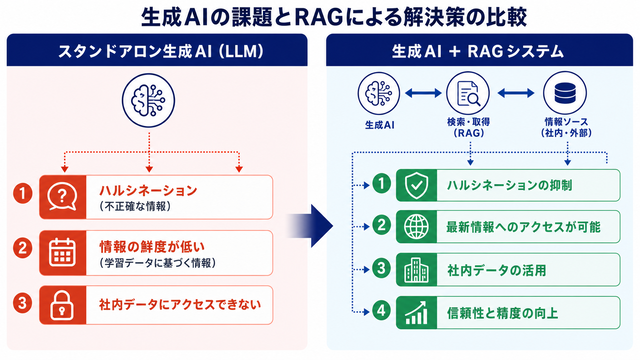
RAGが必要とされる主な理由は、生成AIが単体で抱える「ハルシネーション」と「情報の鮮度」という二つの重大な課題を効果的に解決できるためです。多くの企業がChatGPTに代表される生成AIの導入を検討する一方で、その実用化にはいくつかのハードルが存在します。特に、ビジネスにおける意思決定や顧客対応で利用する場合、AIが生成する情報の正確性と信頼性は絶対条件となります。RAGは、この絶対条件を満たすための現実的な解決策を提供します。
生成AIは非常に強力なツールですが、万能ではありません。その限界を正しく理解し、適切な技術で補うことが、DX推進を成功させる上で不可欠です。RAGは、生成AIの弱点を補強し、そのポテンシャルを安全かつ最大限に引き出すための重要な役割を果たす技術と言えるでしょう。ここでは、生成AIが抱える具体的な課題と、それをRAGがどのように解決するのかを解説します。
生成AIの課題とRAGによる解決策
| 課題 | 生成AI単体の場合 | RAG導入後の解決策 | ビジネスリスク |
|---|---|---|---|
| ハルシネーション | 事実に基づかない情報を生成する可能性 | 信頼できる情報源から引用し、根拠を提示 | 誤った意思決定、顧客からの信用失墜 |
| 情報鮮度・社内データ対応 | 学習データ時点の情報に限定、社内データ利用不可 | 外部DBや社内ナレッジをリアルタイム参照 | 情報陳腐化、業務効率低下、機会損失 |
| 回答の根拠不明瞭 | 回答生成の学習データがブラックボックス | 参照元を明示し、透明性を確保 | 回答の検証困難、利用者の不安 |
生成AIの「ハルシネーション」問題とそのリスク
ハルシネーションとは、生成AIが事実に基づかない情報や文脈と無関係な内容を、あたかも真実であるかのように生成する現象であり、ビジネスにおいては誤った意思決定や信用の失墜といった深刻なリスクをもたらします。
例えば、AIに法規制について質問した際に、存在しない条文を引用して回答したり、顧客への回答文案を作成させた際に、自社製品にない機能をあるかのように記述してしまったりするケースが考えられます。このような誤った情報に基づいて業務を進めれば、コンプライアンス違反や顧客からのクレームにつながりかねません。
RAGは、このハルシネーションのリスクを大幅に低減します。なぜなら、RAGはAIが回答を「創作」する前に、信頼できる情報源(例:最新の法規制データベース、自社の製品マニュアル)から関連情報を検索し、その内容に基づいて回答を生成するからです。これにより、回答は事実に基づいたものになりやすくなり、さらに「どの文書のどの部分を参考にしたか」という根拠を提示することも可能になります。結果として、利用者はAIの回答を安心して業務に活用できるようになるのです。
最新情報や社内データへの対応が困難な課題
生成AI単体では、標準的な学習データに含まれていない最新情報や機密性の高い社内文書へ直接対応することが困難な場合があり、これがビジネスにおける迅速な意思決定や社内情報活用のハードルとなることがあります。近年ではWeb検索機能を備えた生成AIツールも増えていますが、外部に公開されていない社内独自のデータやナレッジを活用するには、依然として適切な仕組みが必要です。
例えば、2026年9月現在、一般的な生成AIの学習データは過去の特定時点のものであり、昨日発表された新製品の情報や、刻一刻と変わる市場の動向については回答できません。また、セキュリティの観点から、企業の内部情報や個人情報を含むデータをAIに学習させることは困難です。
この課題に対し、RAGは明確な解決策を提示します。RAGは、生成AIのモデル自体を再学習させることなく、外部のデータベースを「参照」する形で最新情報や社内データを利用します。具体的には、社内のナレッジベースや顧客管理システム(CRM)、リアルタイムのニュースフィードなどをRAGの検索対象とすることで、AIは常に最新かつ社内の文脈に沿った回答を生成できるようになります。これにより、従業員は「今年の営業戦略に関する最新の議事録を要約して」といった、これまで不可能だった質問をAIに入力することが可能になるのです。
RAGはどのように機能する?その仕組みを分かりやすく解説
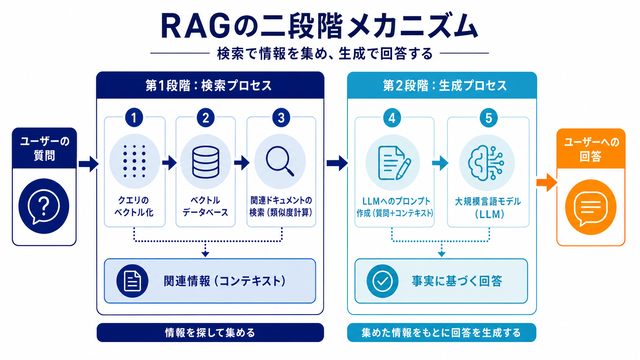
RAGは、ユーザーの質問に対してまず関連情報を知識ベースから「検索(Retrieval)」し、その検索結果を基に大規模言語モデル(LLM)が回答を「生成(Generation)」するという、2段階のプロセスで機能します。
LLMとRAGの違いを理解することも重要です。LLMは膨大な知識を持つ「頭脳」そのものであり、RAGはその頭脳がより正確な答えを導き出すために、外部の信頼できる情報源へアクセスする「手段」や「プロセス」を提供します。
この2段階のアーキテクチャにより、RAGはLLM単体では実現できなかった「根拠のある回答」と「情報の最新性」を両立させます。ユーザーからの複雑な質問に対しても、単に記憶を頼りに答えるのではなく、関連資料を調べた上で回答を組み立てる、専門家に近い質の高い応答が可能になるのです。以下では、この「検索」と「生成」の各プロセスがどのように連携し、質の高い回答を生み出すのかを解説します。
関連情報「検索(Retrieval)」のプロセス
検索プロセスでは、ユーザーからの質問(プロンプト)を「ベクトル」と呼ばれる数値の羅列に変換し、事前に同じくベクトル化して保存しておいた知識ベースとの類似度を計算することで、関連性の高い情報を瞬時に特定します。この「ベクトル検索」という技術がRAGの中核を担っています。まず、社内マニュアルやデータベース、Webサイトなどの文書データを、あらかじめ意味の塊ごとに分割し、それぞれの内容を表現するベクトルに変換して「ベクトルデータベース」に格納しておきます。
ユーザーから質問が入力されると、その質問文も同様にベクトルに変換されます。そして、この質問ベクトルとデータベース内の文書ベクトルとの距離(類似度)を計算し、最も近い、つまり意味的に最も関連性の高い文書を複数選び出します。この仕組みにより、キーワードが完全に一致しなくても、文脈や意図が近い情報を的確に見つけ出すことが可能になります。この高速かつ高精度な情報検索が、次の生成プロセスの土台となるのです。
情報を基にした「生成(Generation)」のプロセス
生成プロセスでは、検索プロセスで得られた関連性の高い情報(コンテキスト)とユーザーの元の質問を組み合わせ、これを大規模言語モデル(LLM)への新しい指示(プロンプト)として渡すことで、根拠に基づいた正確で文脈に沿った回答を生成させます。具体的には、「『検索で見つかった以下の情報を参考にして』、元の質問に答えてください」という形式のプロンプトが内部的に作成されます。これにより、LLMは自身の内部知識だけに頼るのではなく、提供された外部情報を最優先の根拠として回答を組み立てるようになります。
例えば、ChatGPTのような汎用LLMにRAGを組み合わせることで、特定の業務に特化した専門的なAIアシスタントを構築できます。検索された情報源を回答に併記させることで、ユーザーはAIの回答の正しさを容易に検証でき、ハルシネーションのリスクを大幅に抑制できます。このように、検索と生成を有機的に連携させることが、RAGが高品質な回答を生み出す仕組みの核心です。
RAG導入で得られるDX推進上のメリットと考慮すべき点
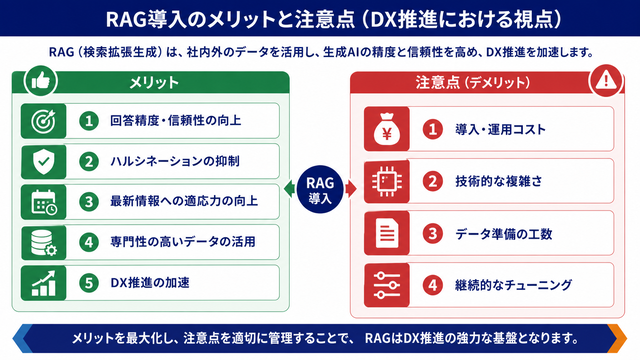
RAGを導入する最大のメリットは、生成AIの回答精度と信頼性を飛躍的に向上させ、最新の社内データを安全に活用できる点にありますが、一方で導入・運用にはコストと技術的な複雑性が伴います。DXを推進する企画担当者にとって、RAGは生成AIを試験的なツールから「信頼できる業務ツール」へと昇華させるための重要な技術です。しかし、その導入は単にツールを導入するような簡単なものではなく、戦略的な計画と投資、そして専門知識が求められます。RAGのメリットを最大限に享受し、潜在的な課題(デメリット)を乗り越えるためには、両側面を正しく理解することが不可欠です。
顧客対応の品質向上、従業員の情報検索時間の削減、データに基づいた迅速な意思決定など、その効果は多岐にわたります。ここでは、RAGがもたらす具体的なメリットと、導入を検討する上で見過ごせない考慮点について網羅的に解説します。
RAG導入のメリットと考慮点
| 項目 | メリット | 考慮点(デメリット) |
|---|---|---|
| 回答精度・信頼性 | ハルシネーション抑制、根拠明示で信頼性向上 | 参照する知識ベースの品質に依存 |
| 情報鮮度・社内データ活用 | 最新情報や機密性の高い社内データを活用可能 | データ整備、ベクトル化、DB構築の手間とコスト |
| 開発・運用コスト | LLMの再学習不要でコスト削減 | RAGシステム自体の構築・運用コスト、専門知識が必要 |
| 導入プロセス | スモールスタートで効果検証が可能 | 既存システムとの連携、セキュリティ対策の複雑性 |
| ビジネス価値 | 顧客サポート、社内ナレッジ活用、意思決定の高度化 | 導入効果の測定、ROIの明確化が課題となる場合も |
生成AIの回答精度と信頼性の向上
RAGは、回答の根拠となる情報を外部の信頼できるソースから引用するため、ハルシネーションを大幅に抑制し、出力結果の事実確認を容易にすることで、AIの回答に対する信頼性を高めます。LLM単体では、なぜその回答に至ったのかというプロセスが不透明な「ブラックボックス」になりがちです。しかし、RAGを導入すれば、「社内規定文書Aの第3章に基づいて回答します」といったように、回答の根拠を明確に提示できます。これにより、利用者は回答の正しさを自分自身で検証でき、安心して業務に活用することができます。
特に、金融、医療、法務といった正確性が厳しく求められる領域において、この信頼性の向上は計り知れない価値を持ちます。コンプライアンス遵守やリスク管理の観点からも、根拠が不明確なAIの回答を業務利用することは許容されません。RAGは、生成AIに「説明責任」を持たせることを可能にし、企業が責任を持ってAI技術を導入・運用するための基盤を提供するのです。
最新情報や専門データへの対応力強化
RAGを導入することで、生成AIはリアルタイムで更新されるデータベースや専門的な社内ナレッジにアクセス可能となり、常に最新かつ正確な情報に基づいた回答を生成できます。企業の競争力は、いかに迅速に最新の情報を活用し、意思決定に反映させるかにかかっています。
RAGは、日々蓄積される営業報告、市場データ、技術文書、顧客からのフィードバックといった生きた情報を、即座にAIの知識として活用する道を開きます。これにより、LLMの再学習にかかる莫大なコストと時間をかけることなく、AIを常に最新の状態に保つことが可能になります。
例えば、営業担当者が顧客訪問前に「A社に関する最新の取引履歴と関連ニュースを要約して」とAIに指示すれば、CRMデータや外部ニュースソースからリアルタイムで情報を収集・要約し、最適な提案のヒントを提供します。このように、組織内に散在する専門データをAIを通じて誰もが活用できるようになることで、属人化の解消や組織全体の知識レベルの底上げにも貢献し、DXを強力に推進します。
導入・運用におけるコストと複雑性
RAGシステムの導入には、知識ベースの構築やデータのベクトル化、検索エンジンの選定・維持といった専門知識が必要であり、これに伴う開発コストや運用リソースが主な課題となります。これが「RAGのデメリット」として挙げられる点です。
まず、RAGの性能は参照する知識ベースの品質に大きく依存するため、社内に散在する文書を整理・クレンジングし、最新の状態に保つためのデータマネジメント体制が不可欠です。次に、これらのデータを効率的に検索可能にするためのベクトルデータベースの構築と運用には、専門的な技術スキルが求められます。
また、ユーザーの質問の意図を正確に汲み取り、最適な情報を検索・生成するためのチューニング(プロンプトエンジニアリングや検索アルゴリズムの調整)も継続的に必要です。これらの構築・運用には、クラウドサービスの利用料や専門人材の確保といったコストが発生します。したがって、RAG導入にあたっては、解決したい課題を明確にし、投資対効果を慎重に見極めながら、スモールスタートでPoC(概念実証)から始めることが賢明なアプローチと言えるでしょう。
RAGの具体的な活用シーンとDX推進における可能性
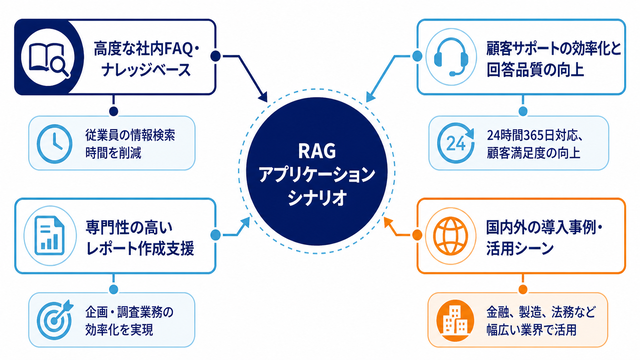
RAGは、社内ナレッジの検索、顧客サポートの自動化、専門的なレポート作成支援など、多様なビジネスシーンで活用でき、DX推進を大幅に加速させる可能性を秘めています。
RAGの本質は、組織が持つ独自の知識やデータを、対話形式で誰もが簡単に引き出せるようにする点にあります。これにより、これまで情報へのアクセスに費やしていた膨大な時間が削減され、従業員はより創造的で付加価値の高い業務に集中できるようになります。
RAGの導入は、単なる業務効率化に留まりません。組織内に埋もれていた暗黙知を形式知化し、全社的なナレッジマネジメントの高度化にもつながります。ここでは、RAGが実際にどのようなビジネスシーンで価値を発揮するのか、具体的な活用例を挙げながら、その可能性を探ります。
社内FAQ・ナレッジベースの高度化
RAGは、社内規定や業務マニュアル、過去の議事録などを知識ベースとすることで、従業員が自然言語で質問するだけで、膨大な資料の中から必要な情報を正確かつ即座に入手できるようにします。従来のキーワード検索では、求める情報がどの文書にあるか見当をつけ、複数の文書を読み比べる必要がありました。しかしRAGを活用した社内チャットボットがあれば、「2026年度の経費精算の上限額と申請手順を教えて」と質問するだけで、関連する複数の規定文書から情報を抽出し、要約して分かりやすく回答してくれます。
これにより、人事、総務、経理といったバックオフィス部門への定型的な問い合わせが大幅に削減され、担当者はより専門的な業務に集中できます。また、新入社員や部署異動者も、必要な情報を自律的に見つけられるようになるため、オンボーディングの効率化にも大きく貢献します。社内のあらゆる情報が一元的に、かつ対話形式でアクセス可能になることで、組織全体の生産性向上を実現します。
顧客サポートの効率化と回答品質向上
RAGは、製品マニュアルや過去の問い合わせ履歴(FAQ)、トラブルシューティングガイドなどを知識ベースに活用することで、顧客サポート担当者やチャットボットが、より迅速かつ一貫性のある高品質な回答を提供できるようにします。顧客からの問い合わせに対して、担当者が複数のシステムや文書を横断して情報を探す手間が省け、回答までの時間を大幅に短縮できます。AIが関連情報を提示してくれるため、経験の浅いオペレーターでもベテランと同レベルの回答品質を維持しやすくなり、属人化を防ぎます。
さらに、Webサイト上のチャットボットにRAGを組み込めば、24時間365日、顧客の複雑な質問に対しても的確な一次回答が可能になります。これにより、簡単な質問はチャットボットが自己解決し、人間はより高度な対応が必要な案件に集中できるため、コールセンター全体の業務効率と顧客満足度の両方を向上させることができます。回答の根拠も示せるため、顧客は安心してその情報を受け取ることができます。
専門情報を用いたレポート作成支援
RAGは、市場調査データ、業界レポート、財務情報、法規制に関する文書などを知識ベースに組み込むことで、専門性の高いレポートや分析資料の作成を支援し、企画・調査部門の業務効率を大幅に向上させます。
例えば、マーケティング担当者が「最新の市場動向レポートと過去3年間の自社売上データを基に、来期の事業戦略に関する示唆をまとめて」と指示するだけで、RAGは指定された複数の文書やデータを横断的に分析し、レポートの草案を生成します。
人間は、AIが生成した草案を基に、より深い考察や戦略的な判断を加えることに集中できます。これにより、情報収集やデータ整理といった時間のかかる作業から解放され、企画立案や意思決定といった本来注力すべき業務に多くの時間を割けるようになります。RAGは、データドリブンな意思決定を組織に根付かせ、ビジネスの競争力を高めるための有効な手段となります。
国内外におけるRAGの導入事例・ケーススタディ
2026年現在、国内外の先進企業はすでにRAGの導入を進め、具体的な成果を上げています。例えば、金融業界では、数千ページに及ぶ金融商品のレポートを知識ベースに、営業担当者が最適な商品を根拠と共に提案するシステムを構築し、提案作成時間を大幅に削減しました。
また、製造業界では、世界中の工場の技術報告書をRAGで横断検索可能にし、若手技術者がトラブルシューティングの際に過去の類似事例を即座に参照できる仕組みを導入しました。さらに法務分野では、膨大な判例データベースと連携させ、リーガルリサーチの時間を大幅に短縮するなど、専門性の高い領域での活用が急速に進んでいます。
RAGとファインチューニングの違いは?他の技術との比較
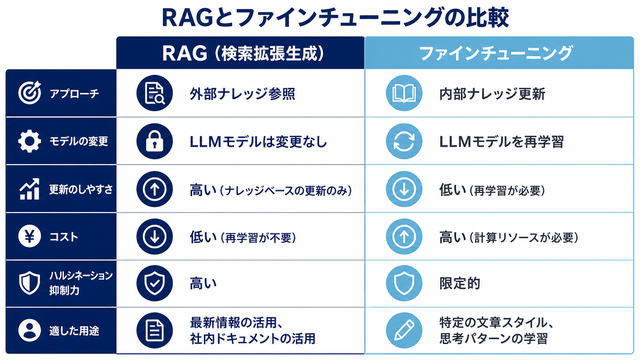
RAGの導入を検討する際、しばしば比較対象となるのが「ファインチューニング」という技術です。どちらも生成AIを特定の業務に特化させる手法ですが、そのアプローチと特性は大きく異なります。ここでは両者の違いを理解し、どちらが自社の課題に適しているかを判断するためのポイントを解説します。
アプローチの違い:外部知識の参照 vs 内部知識の更新
RAG(検索拡張生成)は、LLM本体は変更せず、回答生成時に外部の知識ベースからリアルタイムで情報を「検索」し、それを「参照」して回答を生成するアプローチです。これは例えるなら、優秀な専門家が最新の文献や資料を都度調べながら回答するようなものです。一方、ファインチューニングは、特定のデータセットを用いてLLMのモデル自体を「再学習」させ、モデルの内部知識を更新・調整するアプローチです。特定の文体や対話スタイルなどをAIに反映させるのに適しています。
コストと更新性の比較
情報の更新性において、RAGは知識ベースのドキュメントを更新するだけで最新情報に対応できるため、迅速かつ低コストです。対照的に、ファインチューニングは情報が更新されるたびにモデルの再学習が必要となり、時間と計算コストがかかります。また、RAGは回答の根拠を外部情報に求めるためハルシネーションを抑制する効果が高いのに対し、ファインチューニングは学習データにないことについては依然としてハルシネーションを起こす可能性があります。
どちらを選ぶべきか?使い分けのポイント
課題に応じて最適な手法は異なります。RAGが適しているのは、最新情報や社内文書など頻繁に更新される情報を扱い、回答の正確性を担保したい場合です。ファインチューニングが適しているのは、AIに特定の文体や口調、思考パターンそのものを学習させたい場合です。近年では、両者を組み合わせるハイブリッドアプローチも注目されており、それぞれの長所を活かした、より高度なAIの実現が期待されています。
RAG導入のための具体的な4ステップ
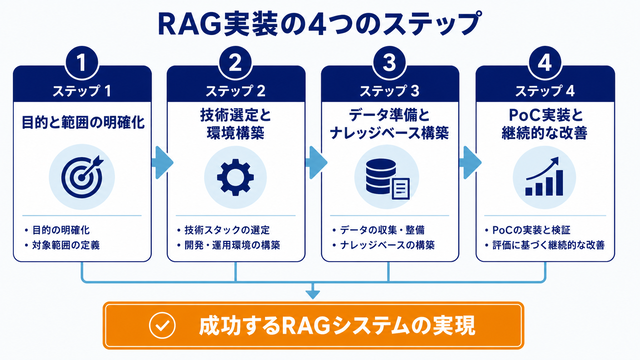
RAGシステムの導入は、無計画に進めるのではなく、計画的なアプローチが求められます。ここでは、DX企画担当者がプロジェクトを推進する上で参考となる、具体的な4つのステップを紹介します。
Step 1: 目的とスコープの明確化
最初のステップは、RAGを導入して「何を解決したいのか」を具体的に定義することです。例えば、「営業部門における提案書作成時間を30%削減する」といった定量的な目標を設定します。同時に、対象とする業務範囲(スコープ)と、知識ベースとして使用するデータ(社内規定、マニュアルなど)を特定し、関係部署と合意形成を図ります。
Step 2: 技術選定と環境構築
次に、システムを構成する技術要素を選定します。具体的には、①回答を生成するLLM(OpenAIのGPTシリーズなど)、②文書をベクトル化して格納するベクトルデータベース、③これらを連携させるフレームワークの選定が必要です。自社のセキュリティポリシーや既存システムとの連携を考慮し、全体のアーキテクチャを設計します。
Step 3: データ準備と知識ベース構築
RAGの性能は、知識ベースとなるデータの品質に大きく左右されます。対象となる文書データを収集し、不要な情報を取り除く「クレンジング」や、AIが読み込みやすい形式に整える「前処理」を行います。その後、文書を意味のある塊に分割し、ベクトル化してデータベースに格納します。このデータパイプラインの整備がプロジェクトの成否を分ける重要な作業です。
Step 4: PoC実施と継続的な改善
すべてのデータを最初から対象にするのではなく、限定されたスコープでPoC(概念実証)を実施します。プロトタイプを構築して実際の業務担当者に利用してもらい、回答の精度や使い勝手についてフィードバックを収集します。そのフィードバックに基づき、検索精度のチューニングやプロンプトの改善といったサイクルを回し、継続的にシステムを改善していくことが成功の鍵です。
RAG導入を成功させるためのDX企画担当者への提言
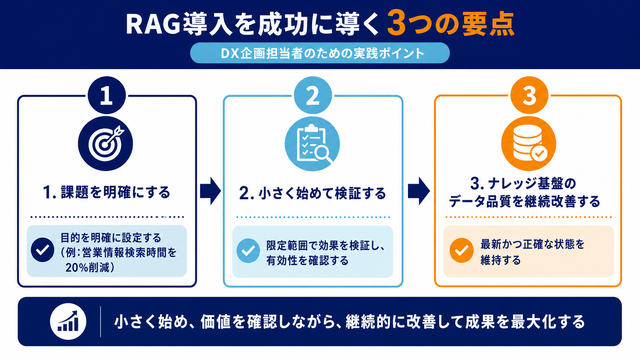
RAG導入を成功させる鍵は、解決したいビジネス課題を明確に定義し、スモールスタートでPoC(概念実証)を実施し、知識ベースとなるデータの品質を継続的に改善していくことです。DX企画担当者がRAGの導入プロジェクトを推進する際には、技術的な側面だけでなく、ビジネス上の目的を常に中心に据える必要があります。
「AIを導入すること」が目的化してしまわないよう、まずは「どの部署の、どの業務の、どのような課題を解決したいのか」を具体的に特定することが最初のステップです。例えば、「営業部門の情報検索時間を月20%削減する」「顧客サポートの一次回答率を30%向上させる」といった明確な目標を設定します。
次に、その目標達成に最も効果的な、限定された範囲のデータ(特定の製品マニュアルやFAQなど)を用いてPoCを開始します。これにより、比較的小さな投資でRAGの有効性を検証し、技術的な課題や運用上の注意点を洗い出すことができます。PoCで得られた成果と学びを基に、経営層や関連部署の理解を得ながら、対象とするデータや業務の範囲を段階的に拡大していくアプローチが、失敗のリスクを抑え、着実な成果を生み出す上で重要です。また、知識ベースのデータは一度構築して終わりではなく、常に最新かつ正確な状態に保つための維持・管理体制を構築することも成功に不可欠な要素です。
まとめ:RAGで生成AI活用の新たな可能性を開く
RAGは、生成AIが持つ「ハルシネーション」や「情報の鮮度」といった根本的な課題を克服し、そのポテンシャルをビジネスの現場で最大限に引き出すための不可欠な技術です。本記事では、DX推進の企画担当者が知るべきRAGの基本概念から、その仕組み、導入メリットと考慮点、そして具体的な活用シーンまでを解説しました。
RAGは、生成AIに外部の信頼できる知識源を参照させることで、回答の正確性と信頼性を飛躍的に高めます。これにより、AIを社内ナレッジ検索の高度化、顧客サポートの品質向上、専門的なレポート作成支援など、企業のコア業務に安心して組み込むことが可能になります。
2026年以降、生成AIの活用は企業の競争力を左右する重要な要素となります。その中で、単に汎用的なAIツールを利用するだけでなく、自社の独自データと連携させるRAGのような技術をいかに戦略的に導入・活用できるかが、他社との差別化を図る上での鍵となるでしょう。導入にはデータ整備やコストといった課題も伴いますが、明確な目的意識を持ってスモールスタートで取り組むことで、その価値を確実に享受できます。RAGを理解し、活用することは、まさに生成AI活用の新たな可能性を開き、自社のDXを次のステージへと進めるための第一歩となるのです。