
ローカルLLMのおすすめ11選!失敗しない選び方や導入手順も解説【2026年最新】
機密情報を扱う業務や、APIの利用料金を気にせず開発に没頭したいとき、手元のPCで高性能な言語モデルを動かせたら、と考えた経験はないでしょうか。近年、オープンソースの大規模言語モデル(LLM)は目覚ましい進化を遂げ、個人のPCでも十分に活用できる時代になりました。
しかし、選択肢が多すぎて「どのモデルが自分の目的に合っているのか」「どのようなPCスペックが必要なのか」と悩む方も多くいます。本記事では、おすすめのローカルLLMを11モデル厳選して紹介します。
ローカルLLMを自社で活用する方法を具体的に知りたい方は、社内ネットワーク内で安全に使えるAI環境「Nenoa」もあわせてご覧ください。
ローカルLLMとは
ローカルLLMとは、クラウド上のサーバーではなく、自分自身のコンピューター(PCやオンプレミスサーバー)の内部で直接実行する大規模言語モデルのことです。インターネット接続を必要とせず、手元の環境(ローカル環境)で完結するため、セキュリティやコスト面で大きなメリットがあります。
データが外部に送信されないため、機密情報や個人情報を扱う業務でも情報漏洩のリスクを気にせず安心して利用できるのが大きな特徴です。
ローカルLLMとクラウド型の違い
ローカルLLMと、ChatGPTに代表されるクラウド型LLMの大きな違いは、モデルがどこで動くかです。動作場所の違いが、セキュリティやコスト、カスタマイズ性など、さまざまな側面に影響を与えます。
両者の特徴を比較すると、それぞれの利点と欠点がより明確になります。
| 項目 | ローカルLLM | クラウド型LLM (例: ChatGPT) |
|---|---|---|
| 動作場所 | ユーザー自身のPC・サーバー | サービス提供者のサーバー (クラウド) |
| データ管理 | 完全に自己管理 (データは外部に出ない) | サービス提供者に依存 |
| セキュリティ | 非常に高い (情報漏洩リスクが低い) | 提供者のセキュリティレベルに依存 |
| コスト構造 | 初期投資 (ハードウェア) + 電気代 | 従量課金 (API利用料) またはサブスクリプション |
| カスタマイズ性 | 高い (モデルの調整や組み込みが自由) | 制限あり (提供される範囲内) |
| 応答速度 | GPUのスペックに依存 | ネットワーク環境やサーバーの負荷に依存 |
| 運用・保守 | 自己責任 (アップデートや管理が必要) | 提供者が実施 (常に最新状態) |
| オフライン利用 | 可能 | 不可能 |
ローカルLLM導入のメリット
ローカルLLMならではのメリットは、特にビジネスシーンや開発現場で大きな価値を発揮します。主なメリットを3つのポイントに整理しました。
【鉄壁のセキュリティ】
データが外部サーバーに送信されることが一切ないため、機密情報や個人情報が含まれる文書の要約や分析も、情報漏洩のリスクを心配することなく行えます。これは金融、医療、法務など、厳格なデータ管理が求められる業界にとって決定的な利点です。
【コストの最適化】
クラウド型APIの従量課金は、利用量が増えるほどコストが膨らみます。一方、ローカルLLMは初期のハードウェア投資が必要ですが、一度環境を構築すればAPI利用料はかからず、ランニングコストは電気代のみです。
利用頻度が高い場合、長期的には大幅なコスト削減につながります。
【自由なカスタマイズ】
オープンソースのモデルをベースに、特定の業務知識を追加学習させるファインチューニングや、社内文書と連携させるRAG(Retrieval-Augmented Generation)の構築が自由に行えます。これにより、自社のニーズに特化した専用AIの開発が可能です。
導入前に知っておくべきデメリット
多くのメリットがある一方で、ローカルLLMには導入前に理解しておくべきデメリットも存在します。これらの課題を事前に把握し、対策を検討することが成功の鍵を握ります。
【ハードウェア要件】
高性能なGPU、特に大容量のVRAM (ビデオメモリ) が必要です。初期投資が高額になる場合があります。
【環境構築の手間】
モデルのインストールやライブラリの設定など、ある程度の専門知識が求められることがあります。
【運用・保守の負担】
モデルのアップデートやセキュリティ管理を自分で行う必要があります。クラウドサービスのように自動で最新状態が維持されるわけではありません。
【回答精度の限界】
PCのスペックがモデルの性能の上限を決定します。クラウド上の超巨大モデルと比較すると、性能面で及ばない場合があります。
【関連記事】【2026年最新】ローカルLLMとは?仕組みや導入方法、PCスペック、おすすめモデルを解説
失敗しない!ローカルLLM選定の重要ポイントと多角的な比較軸
ローカルLLMの導入を成功させるためには、自社の目的、利用環境、そして将来的な拡張性を見据えた上で、数あるモデルの中から最適なものを選び抜くプロセスが不可欠です。ここでは、モデル選定で失敗しないために押さえるべき5つの重要な比較軸を、専門的な観点から深掘りして解説します。これらのポイントを多角的に評価することで、貴社にとって「最強」と言えるローカルLLMを見つけることができるでしょう。
商用利用の可否とライセンス確認の重要性
ローカルLLM選定において、技術的な評価以前に必ず確認すべき最重要項目が「商用利用の可否」です。オープンソースとして公開されているモデルでも、そのライセンス形態は様々です。代表的なライセンスにはApache 2.0、MIT Licenseなどがありますが、モデルによっては独自のカスタムライセンスが適用されている場合もあります。
特に注意が必要なのは、「商用利用可」とされていても、利用条件に制限が設けられているケースです。例えば、「月間アクティブユーザー数が一定数を超えるサービスでの利用を制限する」「モデルを組み込んだ製品やSaaSとして再販することを禁止する」といった条項が付随していることがあります。想定していたビジネスモデルでの利用がライセンス違反となれば、提供元からの利用停止要求や、最悪の場合、法的なトラブルに発展するリスクも否定できません。導入前には必ず公式のライセンス文書を精読し、自社のユースケースが許容範囲内にあるかを法務部門とも連携して確認することが極めて重要です。ローカルLLMの個人利用とは異なり、企業としての利用には厳格なコンプライアンスが求められます。
日本語の処理能力・精度を見極める
多くの高性能なローカルLLMは海外で開発されており、その学習データの大部分は英語です。そのため、日本語の処理能力が不十分なモデルを選ぶと、業務利用において致命的な問題が生じます。例えば、以下のような現象が起こり得ます。
-
指示した内容とは異なる、見当違いの回答が生成される。
-
英語を機械的に直訳したような、不自然でぎこちない日本語が出力される。
-
敬語の使い方が不適切であったり、文脈にそぐわない表現が混在したりする。
-
日本の文化や社会常識を前提としたニュアンスを理解できない。
顧客向けの文書作成や社内規定の要約など、自然で精度の高い日本語が求められる業務で利用する場合、モデルの日本語処理能力は妥協できないポイントです。選定時には、日本語のベンチマークスコア(例: Rakuda、JGLUEなど)を確認するだけでなく、実際に自社の業務を想定した複数のプロンプトを入力し、出力の質を比較検証することをおすすめします。特に、SwallowやELYZAのように日本語に特化したチューニングが施されたモデルは、有力な選択肢となるでしょう。
コンテキスト長(トークン数)がもたらす影響
コンテキスト長とは、LLMが一度に処理し、記憶できるテキスト量の上限を示す指標で、「トークン数」で表されます。この数値が大きいほど、より長い文章や複雑な対話の文脈を理解した上での応答が可能になります。特に、複数の社内文書を参照して回答を生成する「RAG(Retrieval-Augmented Generation)」システムを構築する際には、このコンテキスト長がシステムの性能を直接的に左右します。
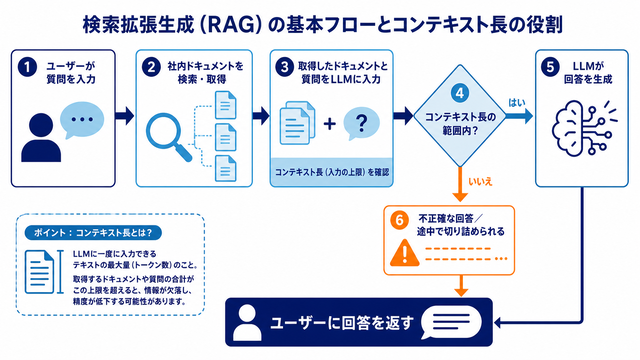
-
ユーザーが質問を入力する。
-
質問に関連する社内文書をナレッジデータベースから検索・取得する。
-
取得した文書の内容と元の質問を合わせて、一つのプロンプトとしてLLMに入力する。
-
LLMが文書の内容を根拠として、質問に対する回答を生成する
このフローにおいて、ステップ3でLLMに入力される「文書の内容+質問」の合計テキスト量が、モデルのコンテキスト長を超えてしまうと、正確な回答を生成できません。一般的なRAGシステムでは32k〜64kトークン(日本語で約2万〜4万文字)程度のコンテキスト長があれば実用的とされていますが、一度に数十ページにわたる技術仕様書や契約書を読み込ませたい場合は、128kトークン以上の対応が望ましいでしょう。Llamaシリーズの一部モデルのように、数百万トークンという超長大なコンテキストに対応するものも登場しており、利用目的に応じた適切なスペックの選定が重要です。
必要な動作環境と要件スペック
ローカルLLMを快適に動作させるためには、相応のコンピューティングリソース、特にGPU(Graphics Processing Unit)とそのVRAM(ビデオメモリ)容量が不可欠です。モデルの性能を左右する「パラメータ数」が大きくなるほど、必要なVRAM容量も増大します。自社で用意できるPCやサーバーのスペックと、導入したいモデルの要求スペックが合致しているかを確認することは、現実的な運用プランを立てる上で欠かせません。
以下に、モデルのパラメータ数と推奨されるVRAM容量のおおよその目安を示します。これは、おすすめのPCスペックを検討する際の重要な指針となります。
| モデル規模(パラメータ数) | 推奨VRAM容量の目安 | 想定されるPC・サーバー |
|---|---|---|
| 7B(70億)程度の軽量モデル | 8GB 〜 12GB | 高性能なゲーミングノートPC、エントリーレベルのワークステーション |
| 14B〜30B(130億〜300億)の中規模モデル | 16GB 〜 24GB | ハイエンドなワークステーション、シングルGPU(RTX 4090 / RTX 6000 Ada等)搭載サーバー |
| 70B(700億)以上の大規模モデル | 48GB 〜 80GB以上 | 複数GPU(RTX 6000 Ada×2基、またはH100/A100等)を搭載した専用AIサーバー |
なお、「量子化(Quantization)」と呼ばれる技術を用いることで、モデルの精度低下を最小限に抑えつつ、必要なメモリ消費量を削減することも可能です。例えば、16ビット浮動小数点数(FP16)で動作するモデルを4ビット整数(INT4)に量子化すれば、VRAM使用量を約1/4に圧縮できます。これにより、スペックが限られた環境でも、より大きなモデルを動作させられる可能性があります。ただし、快適な推論速度を確保するためには、上記の表に示した目安と同等の環境を用意することが推奨されます。
モデルのアーキテクチャ:Dense型とMoE型の違い
LLMの内部構造であるアーキテクチャも、性能や運用効率に影響を与える重要な要素です。現在、主流となっているアーキテクチャは「Dense(密結合)型」と「MoE(Mixture of Experts / 混合専門家)型」の2種類です。
Dense型:
入力された情報(プロンプト)に対して、モデルが持つ全てのパラメータ(知識)を総動員して処理を行います。構造がシンプルで動作が予測しやすく、安定した性能を発揮しやすいのが特徴です。一方で、パラメータ数が増えるほど計算コストが直線的に増加するため、大規模モデルでは推論に時間がかかる傾向があります。
MoE型:
モデル内部に「エキスパート」と呼ばれる複数の専門家ネットワークを持ち、入力内容に応じて最適なエキスパート数個だけを選択して処理を行います。司令塔役の「ゲート」が、プロンプトの内容を判断し、「この質問はAとCのエキスパートに任せよう」といった形で処理を振り分けます。これにより、モデル全体の総パラメータ数が非常に大きくても、推論時に実際に動作するのは一部のパラメータのみとなり、Dense型モデルと比較して計算コストを大幅に抑えながら高い性能を発揮できるという利点があります。近年の高性能モデルでは、このMoEアーキテクチャの採用が増えています。
どちらのアーキテクチャが優れているかは一概には言えず、用途や求める性能、運用環境によって最適な選択は異なります。安定性を重視するならDense型、計算効率と最高性能を追求するならMoE型が、それぞれ有力な候補となるでしょう。
目的別ローカルLLMモデルおすすめ11選【2026年最新】
2026年現在、多種多様なローカルLLMが公開されています。本章では、汎用性・日本語性能・コーディング・軽量さ・特定用途の5つのカテゴリに分け、特におすすめのモデルを11個厳選して紹介します。
各モデルの特徴をまとめた比較表も参考に、ご自身の目的に合ったモデルを見つけてください。
-
GPT-OSS:ChatGPTで有名なOpenAIが開発したローカルLLM
-
Gemma 4:Google製で、論理的思考や数学的推論が得意で安定感がある
-
Llama 4:Meta製「Llama」シリーズの最新モデルで高効率なMoEを採用
-
Qwen3.5:Alibaba製で、日本語性能が非常に高くコストパフォーマンスに優れる
-
Ministral 3:Mistral AI社による小型と高効率に重点を置いたモデル
-
Qwen3 Coder Next:Alibaba製で、コーディング支援に特化した高性能モデル
-
DeepSeek-R1:DeepSeek製で、コーディングベンチマークで高スコアを記録
-
Phi-4:Microsoft製で、スマートフォンでも動作可能なほど軽量かつ高性能
-
Qwen3-1.7B:Alibaba製で、低スペックPCでも快適に動作する軽量モデル
-
plamo-2-translate:国産で、英語から日本語への長文翻訳に特化し高い精度を誇る
-
Nemotron 3 Nano:NVIDIA製で、論理的な説明や数学的な推論が得意
汎用・バランス型
特定の用途に限定せず、チャット、文章作成、アイデア出しなど、幅広く活用したい場合に最適なモデルです。
GPT-OSS
GPT-OSSは、OpenAIが公開したオープンウェイトの大規模言語モデルです。
ローカル環境でも動かしやすい設計が特徴で、推論性能に加えて、ツール利用や長い文脈の処理にも対応しています。コーディングや情報整理のような場面でも活用しやすいモデルとして位置づけられています。
Gemma 4
Googleが開発したGemma 4は、高度な推論と実用性を両立したオープンモデルです。テキストだけでなく画像入力にも対応しており、幅広い業務用途で活用しやすい設計となっています。
比較的少ないVRAMでも動作させやすく、ローカルLLMを初めて試す方にもおすすめです。
Llama 4
Metaが提供する「Llama」シリーズは、モデルの重みを公開し、追加学習や用途別の調整を行いやすいことで広く使われてます。
最新世代の「Llama 4」は、MoEを取り入れた設計が特徴です。なかでも軽量寄りの「Llama 4 Scout」は、最大1000万トークンの長い文脈を扱える点が注目されているモデルです。
これにより、長大な文書の要約や大量のコード、複数資料をまたいだ処理など、長文を一度に扱いたい場面でも活用しやすくなっています。
日本語特化・高性能
日本語の文章作成や読解、要約など、日本語を中心としたタスクで高いパフォーマンスを求める場合に適しています。
Qwen3.5
Alibabaが展開する「Qwen」シリーズは、幅広いモデルをそろえています。日本語で与えられた指示にも対応できるため、国内の業務利用を検討する際にも候補になりやすいモデル群です。
なかでも「Qwen3.5」は、画像を含む入力を扱えるマルチモーダルモデルとして公開されました。ネイティブな視覚言語モデルとして位置づけられており、推論、コーディング、エージェント機能、マルチモーダル理解で高い性能があります。
Ministral 3
Mistralは、フランスのMistral AIが展開する生成AIモデル群で、比較的小さなモデルでも高い性能を目指している点が特徴です。特に「Ministral 3」シリーズには3B、8B、14Bのモデルがあり、ローカル環境を含む幅広いハードウェアで使いやすいよう設計されています。
コーディング特化
プログラムのコード生成、バグの発見、仕様書からのコード作成など、ソフトウェア開発を強力に支援するモデルです。
Qwen3 Coder Next
Qwen3 Coder Nextは、Qwen3系から派生したコーディング向けモデルで、特にコード生成や開発支援、コーディングエージェント用途に強みを持つよう設計されています。
大きな特徴は、パラメータ効率の良さです。MoEアーキテクチャとハイブリッドアテンションを採用することで、ローカル環境でも扱いやすい計算負荷を保ちながら、大規模モデルに近いコーディング支援やエージェント用途での性能を目指した設計になっています。
DeepSeek-R1
こちらもコーディングに特化したローカルLLMです。複雑なアルゴリズムの実装や、既存コードの理解・リファクタリングなど、高度な開発タスクで真価を発揮します。
軽量・低スペックPC向け
VRAM容量が少ないノートPCなど、限られたリソースの環境でも動作するように設計されたモデルです。
Phi-4
Microsoftが開発したPhi-43.5は小規模言語モデル(SLM)に分類され、軽量さが大きな特徴です。モデルサイズが小さいにもかかわらず、多くのタスクで大規模モデルに匹敵する性能を示し、スマートフォン上での動作も可能です。
Qwen3-1.7B
Qwen3シリーズの中でも軽量なモデルの一つです。速度は遅くなるものの、古いPCやGPUを搭載していないノートPCでも、CPUを使って動作させられます。
まずは手軽にローカルLLMを体験してみたい場合に最適です。
特定用途向け
翻訳や数学的推論など、特定の専門分野に特化して性能を追求したモデルです。
plamo-2-translate
日本の開発チームによって作られた、英語から日本語への翻訳に特化した国産モデルです。比較的長い文章の技術文書でも、一度に高精度な翻訳が可能で、専門的な翻訳作業で非常に役立ちます。
Nemotron 3 Nano
NVIDIAが開発したNemotron 3シリーズの小型版です。数学的な問題の解決や、筋道を立てて論理的に説明する能力に優れています。
科学技術計算やデータ分析の分野での活用が期待されます。
失敗しないローカルLLMの選び方
数多くのモデルの中から、自分にとって最適なものを選ぶためには、いくつかの重要なポイントを押さえる必要があります。以下の5つのステップで、選択肢を絞り込んでいきましょう。
1. 用途を明確にする
最初に、何のためにLLMを使いたいかを具体的に定義することが重要です。用途によって最適なモデルは大きく異なります
-
一般的なチャットや文章作成:汎用・バランス型のモデル (Gemma 4, Llama 3.1)
-
日本語の文書要約・校正:日本語特化モデル (Qwen3)
-
プログラミング支援:コーディング特化モデル (DeepSeek Coder)
-
PCスペックに不安がある:軽量モデル (Phi-3.5)
2. PCスペックを確認する
ローカルLLMを選ぶ上で最も重要な制約条件が、お使いのPCのスペック、特にGPUのVRAM(ビデオメモリ)容量です。モデルを快適に動作させるためには、モデルのサイズに対応したVRAMが必要です。
-
8GB:軽量モデルの試用、Q4量子化モデルの実行
-
16GB:多くの高性能モデル、実務導入の標準的なスペック
-
24GB〜:大規模モデルの実行、ファインチューニング、研究開発
また、Macの場合は、Apple Silicon(M1, M2, M3など)の統合メモリがVRAMとして効率的に利用されるため、搭載メモリ量が多いほど有利と言えます。
3. 日本語性能をチェックする
日本語での利用がメインの場合、そのモデルがどれだけ自然で正確な日本語を扱えるかが重要です。Qwen3系のように、日本語の学習データが豊富で、日本のユーザーから高い評価を得ているモデルを選びましょう。
コミュニティのレビューや、ベンチマークサイト(Nejumi LLMリーダーボードなど)の結果も検討に役立ちます。
4. ライセンスを確認する
オープンソースのモデルでも、そのライセンスによっては商用利用が制限されている場合があります。例えば、Apache 2.0ライセンスは比較的自由度が高いですが、モデル独自のライセンスでは特定の条件が課されることもあります。
ビジネスで利用する可能性がある場合は、必ず事前にライセンス条件を確認しましょう。
5. 量子化を理解する
量子化とは、モデルの精度を少しだけ犠牲にすることで、ファイルサイズを大幅に小さくする技術です。例えば、「Q4_K_M」や「Q5_K_M」といった表記が量子化レベルを示します。
VRAMが限られている環境でも、量子化されたモデルを選ぶことで、より大きなモデルを動作させることが可能です。一般的に数字が大きいほど高精度ですが、ファイルサイズも大きくなる点に留意しましょう。
ローカルLLM導入・実行ガイド
かつては専門知識が必要だったローカルLLMの環境構築も、便利なツールの登場により現在では非常に簡単になりました。本章では、手軽で人気のあるツールであるOllamaを使った導入手順を紹介します。
おすすめ実行ツール比較:OllamaとLM Studio
Ollama以外にも、初心者にとって使いやすいツールがあります。以下では、GUI(グラフィカル・ユーザー・インターフェース)で直感的に操作できるLM StudioとOllamaの比較を行います。
| ツール名 | 特徴 | 対象ユーザー |
|---|---|---|
| Ollama | CUI (コマンド) ベースでシンプルかつ手軽。API互換性が高く、他のアプリケーションとの連携も容易。 | エンジニア、開発者、コマンド操作に慣れている方 |
| LM Studio | 完全なGUIで直感的に操作可能。モデルの検索、ダウンロード、チャットがすべて画面上で行える。 | ローカルLLM初心者、非エンジニア、コマンド操作が苦手な方 |
どちらのツールも、ChatGPTのように対話ができるインターフェースを提供しています。手軽さを重視するならOllamaを、GUIでのわかりやすさを求めるならLM Studioを選びましょう。
また、Ollamaをバックエンドで動かし、ブラウザ上でChatGPTのようなUIを提供するOpen WebUIと組み合わせる方法も人気です。
Ollamaを使った導入手順(Windows/Mac対応)
Ollamaを利用するには、まず使用しているOSに対応したインストーラーをダウンロードしてインストールします。以下の公式ページから取得できます。
インストールが完了したら、ターミナル(Windowsの場合はコマンドプロンプトやPowerShell)を開き、Ollamaが正しく導入されているか確認します。次のコマンドを入力してください。
-
ollama –version
コマンドを実行すると、次のようにバージョン情報が表示されます。
-
ollama version is 0.6.8
このようにバージョン番号が表示されれば、Ollamaのセットアップは完了です。
Ollamaを起動したら、HuggingFaceのサイトなどから好きなモデルをダウンロードして組み込めばローカルLLMを動作させることができます。
なお、表示されるバージョンはインストールしたタイミングによって異なります。Ollamaは頻繁にアップデートされているため、できるだけ最新のバージョンを利用することをおすすめします。
まとめ:自社に最適なローカルLLMでAI活用の第一歩を
ローカルLLMは、セキュリティやコスト、カスタマイズ性の面で、クラウド型にはない大きな可能性を秘めています。特に機密情報を扱う企業や、自由なAI開発を求める個人にとって、強力なツールとなることは間違いありません。
まずは、本記事で紹介した軽量モデルとOllamaのような手軽なツールを使って、ローカルLLMの世界を体験してみてはいかがでしょうか。
一方で、企業で実際に導入する際には、セキュリティ性だけでなく、導入のしやすさや運用負荷、社内での利用のしやすさまで含めて検討することが重要です。TDCソフトでは、企業向けプライベートAIアプライアンス「Nenoa」をはじめ、ローカルLLM環境の構築やクラウド型を含めた生成AI活用支援まで、要件に応じたご提案を行っています。
ローカルLLMの導入や社内AIの活用を検討している方は、選択肢の一つとしてTDCソフトの「Nenoa」もご覧ください。
また、ローカルLLMだけでなくクラウド型も含めて、セキュリティに配慮した生成AI活用を進めたい場合は、ぜひTDCソフトにご相談ください。