
ローカルLLMのファインチューニングのやり方を解説。環境設定、情報漏えい回避対策も
IT部門の技術責任者として、生成AIの活用は企業の競争力を左右する重要なテーマです。特に、設計図や顧客情報、財務データといった機密性の高い社内データを安全に活用するためには、外部のクラウドサービスに頼らないアプローチが求められます。
その解決策となるのが、自社管理下の環境で大規模言語モデル(LLM)を最適化する「ローカルLLMファインチューニング」です。この手法を用いることで、セキュリティを最大限に確保しながら、自社の業務に特化した高精度なAIを育成できます。本記事では、ローカルLLMファインチューニングを実現するための具体的な手法、必要なインフラ、コスト、そして避けては通れないセキュリティリスクと、その対策について網羅的に解説します。
ローカルLLMを自社で活用する方法を具体的に知りたい方は、社内ネットワーク内で安全に使えるAI環境「Nenoa」もあわせてご覧ください。
機密データ活用におけるローカルLLMファインチューニングの戦略的意義
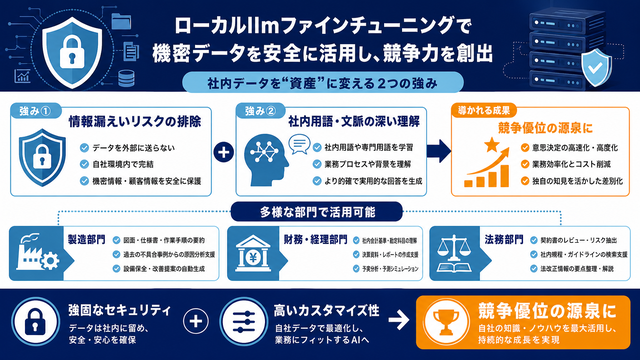
ローカルLLMファインチューニングとは、既存の汎用的な大規模言語モデルに自社の特化データを追加学習させて性能を最適化するプロセスを、自社管理下のローカル環境で実行する戦略です。
これにより、外部へのデータ送信を一切行うことなく情報漏えいリスクを根本的に排除できるため、データセキュリティとコンプライアンス要件が極めて厳しい製造業や金融業において、機密データを安全に活用するための不可欠なアプローチとなります。
LLMにおけるファインチューニングを行う目的は、モデルの「振る舞い」や「出力形式」を特定の業務に最適化することにあります。社内用語や最新情報の参照にはRAG(検索拡張生成)が適している一方で、ファインチューニングは応答のトーン&マナーの統一や専門タスクの挙動の定着に有効です。毎回プロンプトで詳細な指示を与える手間を減らし、安定した高精度の応答を効率的に得ることが可能になります。
このアプローチは、技術責任者が直面するデータガバナンスの課題を解決し、企業の独自データを競争優位性の源泉へと転換させる大きなビジネス価値を持ちます。
具体的な成功事例として、多様な業種での利活用が進んでいます。例えば製造業では、機密性の高い設計図や技術仕様書を学習させ、技術的な質疑応答を自動化するチャットボットを開発し、熟練技術者のノウハウ継承に成功したケースがあります。
金融業では、顧客情報を保護しながら過去の取引データをファインチューニングし、個々の顧客に最適化された金融商品を提案するAIアシスタントの構築が進んでいます。また、企業の法務部門では、膨大な契約書データを学習させ、契約レビューやリスクチェックを自動化することで、業務効率を飛躍的に向上させた事例も報告されています。
これらのケーススタディは、ローカルLLMファインチューニングが各業種のコア業務の生産性を高める強力なソリューションであることを示しています。
ローカルLLMファインチューニングのやり方
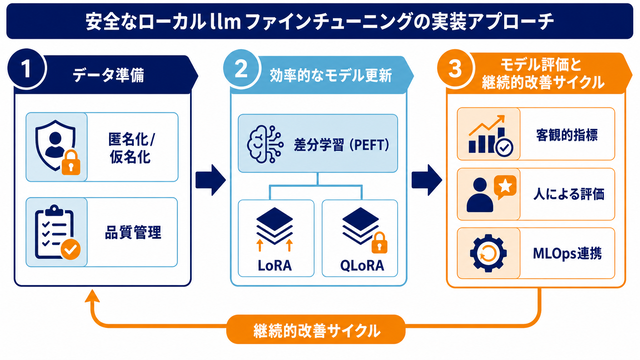
セキュリティを担保したローカルLLMファインチューニングを実装するには、①データの匿名化、②LoRAなどの差分学習、③継続的なモデル評価という3つの主要アプローチが不可欠です。
このアプローチの核心は、企業内部の機密データを活用しつつ、データ漏えいのリスクを技術的・プロセス的に最小化することにあります。具体的には、学習データのプライバシーを保護するための前処理から始まり、限られた計算リソースで効果的にモデルを更新する差分学習技術の適用、そして最終的に業務要件を満たす性能を保証するための厳格な評価と改善のワークフローを構築します。
この一連のプロセスを確立することが、安全かつ効果的な社内専用LLMを実現するための鍵となります。以下では、この実装アプローチを構成する各要素の具体的なやり方について掘り下げていきます。
データ準備:匿名化・仮名化と品質管理の徹底
データ準備における最重要課題は、匿名化・仮名化によってプライバシーを保護し、同時にデータの品質を管理してモデルの学習精度を確保することです。機密情報や個人情報を含む社内データをそのまま学習に利用することは、重大なセキュリティインシデントに直結するため、特定の個人を識別できる情報を完全に除去、あるいは代替の識別子に置き換える処理が必須となります。
これらのデータ前処理プロセスは、プライバシー保護とモデルの性能維持という二つの要件を両立させるための重要な工程です。具体的には、固有表現抽出(NER)技術を用いて個人名や組織名を検出しマスキングする、特定のパターンに合致する情報を削除するサニタイズ処理を行うといった手法があります。
LLMファインチューニング用のデータセットを作成する際は、こうしたプライバシー保護措置と並行して、データの重複排除や誤記修正、フォーマットの統一といった品質管理も徹底し、モデルが正確な知識を学習できる基盤を整える必要があります。
効率的なモデル更新:差分学習(LoRA, QLoRAなど)の適用戦略
LoRAやQLoRAといった差分学習(PEFT)技術は、モデル全体ではなく新たに追加した一部のパラメータのみを更新することで、計算リソースを大幅に抑制しつつLLMを効率的にファインチューニングする戦略です。
LLMのフルファインチューニング(モデルの全パラメータを更新する手法)は、膨大な計算コストとGPUメモリを必要とし、ローカル環境での実践には高いハードルがあります。対照的に、差分学習は元の巨大なモデルの重みを凍結(固定)したまま、新たに追加したごく一部のパラメータ(アダプタ層)のみを学習対象とします。
この「差分」のみを学習するアプローチにより、必要な計算リソースを数十分の一から数百分の一に削減し、ローカル環境におけるLLMの追加学習の実行を現実的なものにします。
LoRA (Low-Rank Adaptation) は、この代表的な手法であり、メモリ使用量を大幅に抑える手法として量子化技術を組み合わせたQLoRAも定着しています。QLoRAはVRAM消費量を削減できる一方、量子化・逆量子化のオーバーヘッドにより学習速度が低下するトレードオフが存在します。現在では目的に応じた派生手法も多数活用されており、重みの「大きさ」と「方向」を分解して学習精度を高めるDoRAなども広く知られています。
実務においては、タスクの複雑さや求められる性能、利用可能なハードウェアスペックを勘案し、これらの差分学習技術から最適なものを選択・実装することが、コスト効率の高いモデル更新を実現する鍵となります。
モデル評価と継続的改善サイクル:社内業務への最適化
モデル評価と継続的改善では、PerplexityやROUGEなどの客観的な評価指標と人手評価を組み合わせ、その結果をMLOpsのCI/CDパイプラインに組み込み、改善サイクルを回し続けることが重要です。
ファインチューニング後のLLMが実業務で価値を発揮するためには、「なんとなく精度が良くなった」という主観的な判断ではなく、タスクに応じた定量的な評価指標を用いて性能を検証します。
例えば、テキスト生成の流暢さを測るPerplexity、生成された要約と正解要約の一致度を測るROUGE、機械翻訳の品質を評価するBLEUなどが代表的です。これらの自動評価指標と、実際の業務担当者による人手評価を組み合わせることで、モデルの性能を多角的に検証します。
さらに、この評価プロセスをMLOps(機械学習基盤)と連携させ、新たなデータが蓄積されるたびに再学習と評価、デプロイを自動的に繰り返すCI/CD(継続的インテグレーション/継続的デリバリー)パイプラインを構築することが理想的です。
この改善サイクルを回し続けることで、LLMは常に最新の社内情報と業務要件に適応し、その価値を最大化していくことができます。
ローカルLLMファインチューニングを支えるインフラ要件と環境構築
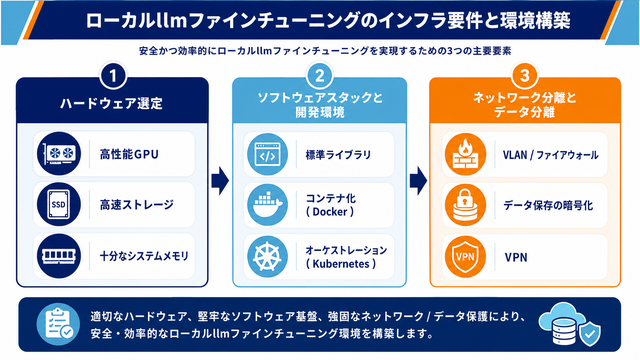
ローカルLLMファインチューニングを支えるインフラは、高性能GPUなどのハードウェア、Docker/Kubernetesによるソフトウェア環境、そしてネットワーク分離によるセキュリティという3つの要素で構成されます。
機密データを扱うファインチューニングを成功させるには、これらの要素を統合したインフラ基盤の構築が前提となり、オンプレミスまたはプライベートクラウド環境において、データ処理からモデル学習、推論サービス提供までの一連のワークフローを円滑かつ安全に実行できる環境を設計する必要があります。
このインフラは、計算能力、開発効率、データ保護という3つの側面から綿密に計画されなければなりません。具体的には、ファインチューニングの規模に応じた適切なハードウェアの選定、コンテナ技術を活用した開発環境の標準化、そして外部からの脅威を遮断し内部のデータを隔離する厳格なネットワーク設計が求められます。
これらの要素が一体となって初めて、セキュアで効率的なローカルLLMファインチューニング基盤が完成します。
【関連記事】社内ネットワークの仕組みとは?基本構成や構築手順、ポイントを解説
ハードウェア選定のポイント:GPU性能、メモリ、ストレージの最適化
ハードウェア選定では、NVIDIA A100/H100のような高性能GPUのVRAM容量を最優先で確保し、それに合わせて高速ストレージ(NVMe SSD)と十分なシステムメモリ(RAM)を最適化することがポイントです。
LLMの学習には膨大な並列計算能力が要求され、コンシューマー向けGPUでは性能が不足し、データセンター向けの高性能GPUが必須となります。特に、NVIDIA A100やその後継であるH100 Tensor Core GPUは、その高い計算性能と大容量のGPUメモリ(VRAM)により、大規模モデルのファインチューニングにおける標準的な選択肢となっています。
選定の際には、モデルのパラメータ数やバッチサイズに応じて必要となるVRAM容量を正確に見積もることが極めて重要です。VRAMが不足すると学習が実行できない、あるいは学習効率が著しく低下するためです。
また、大量の学習データを高速に読み書きするためのNVMe SSDなどの高速ストレージや、大規模なデータセットをメモリ上に展開するための潤沢なシステムメモリ(RAM)も、全体のパフォーマンスを左右する重要な要素として最適化する必要があります。
ソフトウェアスタックと開発環境の構築:コンテナ化とオーケストレーション
ソフトウェア環境の構築では、PyTorchやHugging Faceといった標準ライブラリをDockerでコンテナ化し、Kubernetesでオーケストレーションすることが、再現性と拡張性の高い開発ワークフローを実現する鍵となります。
LLMのファインチューニングでは、機械学習フレームワークであるPyTorchやTensorFlow、そして多様な事前学習済みモデルや学習用ツールキットを提供するHugging FaceのTransformersライブラリが事実上の標準となっています。
これらのライブラリや依存関係は複雑化しがちであり、開発者ごとに環境が異なるといった問題を避けるため、Dockerを用いたコンテナ化が推奨されます。Dockerコンテナによって、ライブラリのバージョンを含めた実行環境全体をコードとして管理し、どのマシン上でも同一の環境を再現できるようになります。
さらに、複数のコンテナや計算ノードを効率的に管理・運用するため、Kubernetesのようなコンテナオーケストレーションツールを導入することで、リソースの割り当てや学習ジョブのスケーリングを自動化し、開発から本番運用までのプロセス全体を効率化することが可能です。
ネットワーク分離とデータ隔離戦略:オンプレミス環境のセキュリティ強化
オンプレミス環境のセキュリティは、LLM関連サーバー群をVLANやファイアウォールで社内ネットワークから完全に分離し、データストレージを暗号化するデータ隔離戦略によって強化します。
この物理的・論理的なネットワーク分離は、機密データを取り扱う上で外部からのサイバー攻撃や内部からの意図せぬ情報漏えいを防ぐために極めて重要であり、多層的な対策によって安全なファインチューニング環境を維持します。
ローカルLLMファインチューニングを行うサーバー群は、インターネットに直接接続された通常の社内ネットワークからは完全に分離された、専用のセキュアなネットワークセグメントに配置する必要があります。この隔離環境は、VLAN(Virtual LAN)による論理的な分割や、ファイアウォールによる厳格な通信制御によって実現します。
外部との通信が必要な場合でも、VPN(Virtual Private Network)を介して暗号化された経路のみを許可し、アクセス元を厳しく制限します。また、ファインチューニングに使用するデータセットや学習済みモデルが保存されるストレージに対しても、保存時(at-rest)と転送時(in-transit)の両方で強力な暗号化を施すことが必須です。
これらの多層的なセキュリティ対策によって、最も重要な資産であるデータをあらゆる脅威から保護し、安全なファインチューニング環境を維持します。
ローカルLLMファインチューニングにおけるセキュリティリスクと多層防御戦略
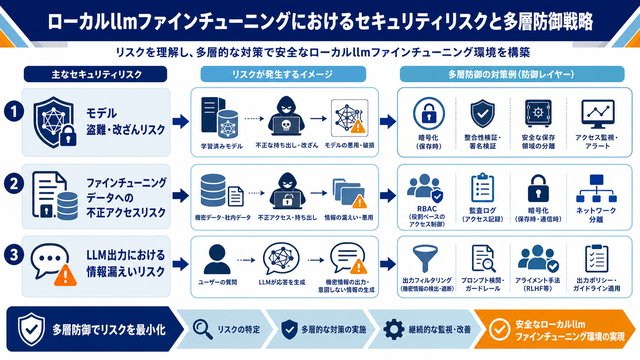
ローカルLLMファインチューニングのセキュリティリスクには、アクセス制御、データ暗号化、出力フィルタリングなどを組み合わせた「多層防御(Defense in Depth)」で対処します。
ローカル環境はクラウドに比べて安全ですが、モデル窃盗、データへの不正アクセス、機密情報の出力といった内部・外部の脅威は依然として存在します。これらの多様なリスクに対して、単一の対策に依存するのではなく、アクセス制御、暗号化、監視、アライメント技術などを組み合わせた「多層防御(Defense in Depth)」のアプローチを取ることが重要です。
技術的な対策と、それを運用するための組織的なルールやプロセスを両輪で整備することで、ローカル環境のセキュリティを最大限に高め、機密データを安全に活用する基盤を確立できます。このセクションでは、具体的なリスクとその実践的な対策について解説します。
【関連記事】情報漏洩対策の完全ガイド|企業の担当者が行うべき具体策と進め方
モデル窃盗・改ざんリスクとその対策:アクセス制御と監査ログ
モデルの窃盗・改ざんリスクには、役割ベースのアクセス制御(RBAC)で権限を最小化し、すべてのアクセスを記録する監査ログを監視することで対策します。ファインチューニングによって生成された独自のLLMは企業の重要な知的資産であり、その保護のために、モデルファイルや学習済みの重みデータが保存されているストレージやリポジトリに対して厳格なアクセス制御を実装することが基本となります。
「最小権限の原則」を徹底し、担当者の職務に応じて必要最小限の権限(読み取り、書き込み、実行)のみを付与します。
誰が、いつ、どのファイルにアクセスしたかをすべて記録する監査ログを有効にし、定期的に監視することで、不正なアクティビティを早期に検知・追跡できる体制を構築することが不可欠です。
また、Git LFS(Large File Storage)のようなツールを用いてモデルのバージョン管理を行い、すべての変更履歴を追跡可能にすることも、意図しない改ざんからの復旧や原因究明に役立ちます。
ファインチューニングデータへの不正アクセス防止策:権限管理と暗号化
データへの不正アクセスは、アクセス権限を特定のサービスアカウントに限定し、ストレージ全体を暗号化(Encryption at Rest)することで防止します。モデルの学習元となった機密データは保護の最重要対象であり、権限管理と暗号化の二重の対策に加え、定期的な脆弱性診断を実施することで、攻撃経路を未然に塞ぐプロアクティブな防御が求められます。
データへのアクセスは特定のサービスアカウントや承認されたユーザーグループに限定し、個人のアカウントからの直接アクセスは原則として禁止するべきです。さらに、データが保存されているストレージ全体を暗号化し、万が一ストレージメディアが物理的に盗難された場合でも、中身を解読できないように保護します。
加えて、定期的に脆弱性診断を実施し、システムやミドルウェアに存在するセキュリティホールを特定・修正することで、攻撃者が侵入する経路を未然に塞ぐプロアクティブな対策が求められます。
LLM出力における情報漏えいリスクとその緩和:アライメントとフィルタリング
LLM出力からの情報漏えいリスクは、RLHFなどのアライメント技術で不適切な出力を抑制し、さらに出力フィルタリングシステムで機密情報を検知・マスキングすることで緩和します。ファインチューニング後のLLMが学習データに含まれていた機密情報を意図せず出力してしまうリスクは深刻であり、これらの技術的対策に加えて、プロンプトエンジニアリングによる誘導もリスク緩和に有効です。
このリスクを緩和するためには、LLMの挙動を人間の意図や倫理観に沿うように調整する「アライメント」技術が重要になります。代表的な手法として、人間のフィードバックを用いた強化学習(RLHF)があり、不適切または危険な出力を抑制するようにモデルを再学習させます。
より直接的な対策としては、LLMの出力段階で特定のキーワードやパターン(例:電話番号、住所、社外秘情報など)を検知し、自動的にマスキングまたはブロックする出力フィルタリングシステムを導入することが有効です。
また、LLMへの入力(プロンプト)を工夫するプロンプトエンジニアリングによって、機密情報に触れるような回答を生成しにくいように誘導することも、リスク緩和の一助となります。特定の応答スタイルを学習させる、ローカルLLMファインチューニングにおけるキャラクター設定も、意図しない情報開示を防ぐ一環として機能します。
導入・運用コストの試算とROI最大化のための考慮事項
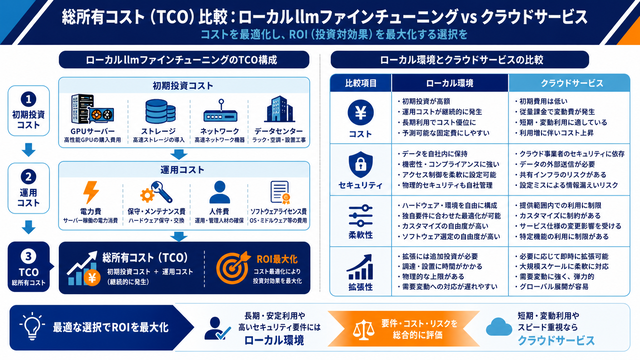
導入・運用のコストを評価するには、初期投資と運用費を合算したTCO(総所有コスト)を算出し、クラウドサービスと比較して総合的なROIを判断することが重要です。ローカルLLMファインチューニングは多大なメリットをもたらす一方で相応のコストを伴うため、技術責任者はコストだけでなく、セキュリティ向上やビジネス機会創出といった価値を含めて費用対効果を最大化する戦略を立てる必要があります。
これらのコストを総合的に評価するTCO(総所有コスト)の観点を持ち、パブリッククラウドが提供するLLMサービスとの比較検討を通じて、自社にとって最適な選択肢を見極めることが重要です。
このプロセスを通じて、単なるコスト削減だけでなく、セキュリティの向上やビジネス機会の創出といった価値を含めた総合的なROIを評価する視点が求められます。
初期投資コストの内訳:GPUサーバー、ストレージ、ネットワーク機器
初期投資コストは、複数台の高性能GPUサーバー(NVIDIA A100/H100等)が中心となり、高速ストレージや専用ネットワーク機器、データセンター設備費用などが主な内訳です。これらのハードウェア購入費用が初期投資の大半を占め、1台あたり数百万円から数千万円に達することもあります。
必要なサーバーの台数は、ファインチューニング対象のモデルサイズや同時に実行する学習ジョブの数によって変動します。費用を見積もる際には、サーバー本体だけでなく、大規模なデータセットを高速に処理するためのNVMe SSDベースのストレージシステムや、サーバー間を広帯域で接続するInfiniBandなどの専用ネットワーク機器のコストも忘れずに計上する必要があります。
これらの周辺機器も全体のパフォーマンスに大きく影響するため、妥協は禁物です。また、これらを設置するためのデータセンターのラックスペースや電源、冷却設備にかかる費用も初期投資の一部として考慮に入れるべきです。このローカルLLMのファインチューニング方法は、初期に大きな投資が必要となる点が特徴です。
運用コストとTCO(総所有コスト)の試算:電力、保守、人件費
運用コストは、GPUサーバーの膨大な電力費、ハードウェアの保守契約費、そして最も重要な専門人材の人件費から構成され、これらを合算してTCO(総所有コスト)を試算します。初期投資だけでなく、これらの継続的に発生するコストを3〜5年といった期間で正確に評価することが、プロジェクト全体の真のコストを把握し、適切な投資判断を行う上で不可欠です。
運用コストの中で最も大きな割合を占める可能性があるのが、高性能GPUサーバーが消費する膨大な電力費です。次に、ハードウェアの故障に備えるための保守契約費用も重要な要素です。24時間365日のオンサイト保守契約は、安定運用には欠かせませんが、ハードウェア購入価格の10〜15%程度が年間で必要となるのが一般的です。
そして、見落とされがちですが最も重要なのが、この高度な環境を構築・運用・活用するための専門人材(AIエンジニア、MLOpsエンジニア)の人件費です。ソフトウェアライセンス費用(有償OSや運用管理ツールなど)も加味し、これらすべての運用コストを3〜5年といった期間で合算し、初期投資と合わせたTCOを算出することで、プロジェクト全体の真のコストを把握できます。
クラウドLLMサービスとの比較検討:費用対効果の最適化
費用対効果の最適化には、ローカル環境(高セキュリティ・高カスタマイズ性)とクラウドサービス(低初期コスト・高スケーラビリティ)の特性を比較し、自社の要件に合致する方を選択することが不可欠です。
導入を決定する前に、Azure OpenAI ServiceやAmazon Bedrockといったパブリッククラウドが提供するLLMファインチューニングサービスとの比較検討は必須のプロセスです。以下の表は、両者の主な違いをまとめたものです。
| 評価項目 | ローカルLLMファインチューニング | クラウドLLMサービス |
|---|---|---|
| コスト | 初期投資が高額。長期的なTCOは利用頻度による。 | 初期投資は不要(従量課金制)。大規模利用では高コストになる可能性。 |
| セキュリティ | 非常に高い。データを外部に出さず、閉域網で完結。 | 高いレベルで提供されるが、データ転送やサービス提供者への依存は残る。 |
| 柔軟性・カスタマイズ性 | 非常に高い。モデル、ライブラリ、インフラを自由に選択・構成可能。 | サービス提供者の仕様に依存。限定的なカスタマイズのみ可能な場合が多い。 |
| 拡張性(スケーラビリティ) | ハードウェアの物理的な増設が必要。時間とコストがかかる。 | 非常に高い。必要に応じてリソースを即座にスケールアップ/ダウン可能。 |
特に、ローカル環境でのスケーラビリティは重要な検討事項です。需要の急増や、より大規模なモデルへの移行が必要になった際、クラウドのように即座にリソースを追加することは困難で、ハードウェアの調達には時間とコストがかかります。
この課題に対しては、プロジェクト初期から将来的な拡張を見越したインフラ設計を行うことや、モデルの蒸留・量子化といった技術で推論を最適化し、少ないリソースで対応できるようにするアプローチが考えられます。計画的なインフラ投資と技術的な工夫によって、物理的な制約を乗り越え長期的な運用を見据えることが可能です。
どちらが最適かは、企業のセキュリティポリシー、予算、技術力、そしてLLMの利用目的によって異なります。
最高レベルのセキュリティと自由なカスタマイズ性を求めるならローカル環境が、初期投資を抑え迅速に始めたい、あるいは需要の変動が激しい場合はクラウドサービスが有力な選択肢となります。
これらのトレードオフを総合的に評価し、自社の戦略に最も合致する方法を選択することが費用対効果の最適化につながります。
企業内でのローカルLLMファインチューニング導入プロジェクト推進のロードマップ
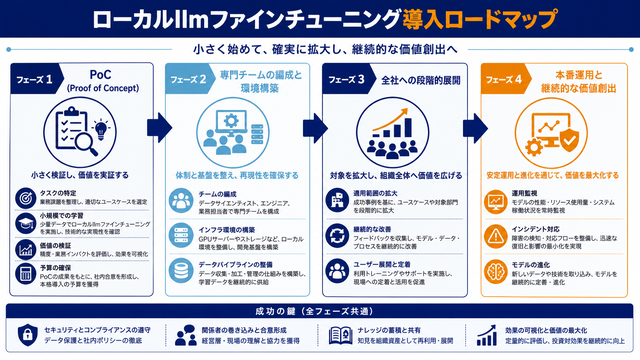
導入プロジェクトの推進ロードマップは、小規模な実証実験(PoC)から始め、その成果を基に専門チームを組成し、段階的に全社展開へとスケールアップしていくアプローチを取るべきです。
技術責任者がプロジェクトを成功に導くには、こうした段階的な導入計画を策定し、各フェーズでの目標や成果物を明確に定義して関係者間の共通認識を醸成しながら進めることが不可欠です。プロジェクトの推進には、AIエンジニア、インフラエンジニア、データサイエンティスト、そして事業部門の担当者から成る専門チームの体制構築が鍵となります。
このロードマップに従い、各フェーズでの目標、成果物、リスクを明確に定義し、関係者間の共通認識を醸成しながら進めることで、手戻りを防ぎ、着実なプロジェクト推進が可能になります。
PoCで技術的な実現可能性とビジネス価値を証明し、その結果をもって経営層から本格的な予算とリソースを獲得し、全社展開へとつなげていくというストーリーを描くことが成功の秘訣です。本番運用への移行プロセスでは、運用監視体制やインシデント対応計画も整備し、継続的な価値創出を目指します。
まとめ:機密データを安全に活用するローカルLLMファインチューニングの未来展望とDX推進への貢献
本記事では、機密性の高い社内データを安全に活用するための強力な手段である、ローカルLLMファインチューニングについて、その戦略的意義から具体的な実装アプローチ、インフラ要件、セキュリティ対策、コスト試算に至るまでを網羅的に解説しました。データセキュリティが最重要課題となる現代において、データを外部に出すことなく自社環境内で完結させるこの手法は、製造業や金融業をはじめとする多くの企業にとって、生成AI活用のスタンダードとなり得ます。差分学習のような効率的な技術の登場により、ローカルLLMファインチューニングはかつてないほど現実的な選択肢となっています。
この取り組みは、単なるITインフラの刷新に留まらず、企業のデジタルトランスフォーメーション(DX)を根幹から支え、データドリブンな意思決定や新たなサービス創出を加速させるエンジンとなります。社内に蓄積された膨大な非構造化データを、真の競争優位性へと転換する旅は、周到な計画と段階的な導入から始まります。次のアクションとして、まずは特定の業務課題を対象とした小規模なPoC(実証実験)を計画し、ローカルLLMファインチューニングがもたらす具体的な価値を社内に示すことから始めてみてはいかがでしょうか。
TDCソフトでは、ローカルLLMの構築・運用や、セキュリティ対策に関するご相談を承っています。
ローカルLLMの導入や社内AIの活用を検討している方は、選択肢の一つとしてTDCソフトの「Nenoa」もご覧ください。