
ローカルLLMの日本語性能と選定基準|PoCから全社展開へ導く成功のステップ
生成AIの業務活用が進む一方、機密情報の漏洩リスクから社内データの活用に踏み切れない企業は少なくありません。この課題を解決するのが、閉じた社内環境でAIを動かす「ローカルLLM」です。本記事では、ローカルLLMの基礎知識からクラウドとの違い、日本語モデルの評価基準、PoCから本番導入までの具体的なロードマップを徹底解説します。セキュリティを担保しながら社内ナレッジを活かし、DXを加速させるための戦略的ガイドです。
社内ネットワーク内で安全に使えるAI環境に関心のある方は、「Nenoa」もあわせてご覧ください。
企業のIT戦略におけるローカルLLMの重要性
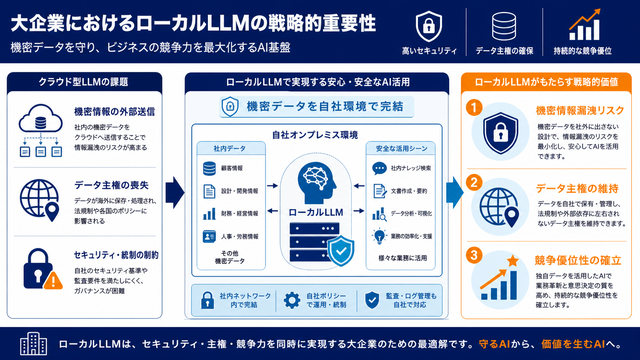
企業のIT戦略においてローカルLLMが重要視される理由は、機密性の高い独自データを安全に活用し、競争優位性を確立できる点にあります。生成AIの業務活用が急速に拡大する一方、多くの企業ではクラウドベースのLLMサービスに社内の機密情報を入力することへの情報漏洩リスクを深刻な課題と捉えています。
特に、技術情報、顧客データ、財務情報といった企業の根幹をなすデータを扱う企業にとって、この懸念はDX推進の大きな障壁となり得ます。
社内に蓄積された膨大な技術文書や顧客対応履歴などの非構造化データは、活用されれば大きな価値を生む「宝の山」です。ローカルLLMは、これらのデータを外部に出すことなく、完全にコントロールされた社内環境で分析・活用する道を開きます。
これにより、データ主権を維持しながら自社専用のナレッジベースや業務効率化ツールを構築することが可能となり、情報システム部門はセキュリティを担保しつつ、ビジネス価値創出に直接貢献する戦略的役割を担うことができるのです。
ローカル環境でAIを動かす「ローカルLLM」とは何か
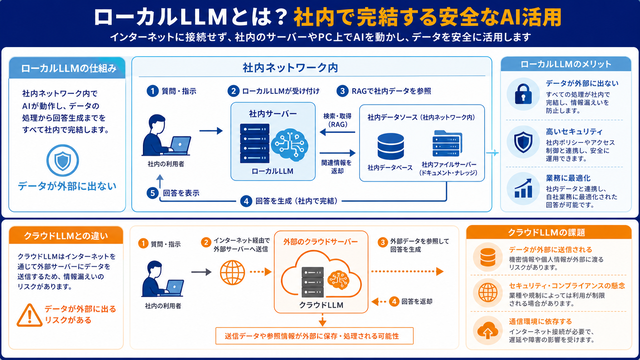
ローカルLLMとは、インターネットを介さず、企業が管理する自社のサーバーやPC上で直接動作させる大規模言語モデルのことです。一般的なクラウド型LLMが、サービス提供者の管理する外部サーバー上で処理を行うのに対し、ローカルLLMはすべての処理が社内ネットワーク内で完結します。
この「データが外部に出ない」という点が、両者の決定的な違いであり、多くの企業が注目する理由です。「ローカルLLMとLLMの違いは何ですか?」という問いへの最も明確な答えは、このデータの処理場所にあります。
情報システム部門の視点では、自社のセキュリティポリシーを適用できるという利点があります。データの保存場所、アクセス権限、通信の暗号化など、すべてを自社の基準で管理・統制できます。
クラウドサービス利用時に発生しがちなシャドーITのリスクや、サービス側の仕様変更に振り回されるといった課題を回避し、安定的かつセキュアなAI活用基盤を構築するための技術的選択肢と言えるでしょう。
ローカルLLMとクラウドLLMの比較
| 項目 | ローカルLLM | クラウドLLM |
|---|---|---|
|
データ処理場所 |
自社サーバー/PC(社内ネットワーク内) |
サービス提供者の外部サーバー(インターネット経由) |
|
セキュリティ |
自社ポリシーで完全管理、情報漏洩リスク最小化 |
サービス提供者のポリシーに依存、情報漏洩リスクが存在 |
|
データガバナンス |
データ主権を完全に維持、監査証跡も自社で管理 |
データ主権の一部をサービス提供者に委ねる |
|
初期費用 |
GPUサーバー等のハードウェア投資が必要 |
基本的に不要(利用料のみ) |
|
運用負荷 |
モデルの導入・保守・アップデートなど自社で対応 |
サービス提供者が運用・保守 |
| カスタマイズ性 | 自社データでのファインチューニングが容易 | API経由での利用が主、ファインチューニングは限定的 |
社内データ活用におけるアーキテクチャ上の利点
ローカルLLMのアーキテクチャ上の最大の利点は、既存の社内データベースやファイルサーバーと低遅延かつセキュアに直接連携できる点です。クラウド型LLMを利用して社内データを活用しようとすると、データを一度クラウドへアップロードするか、API経由で頻繁に通信を行う必要があり、セキュリティリスクや通信遅延、コスト増加といった課題が生じます。しかし、ローカルLLMであれば、社内ネットワーク内の閉じた環境でこれらのデータソースと直接連携することが可能です。
例えば、RAG(Retrieval-Augmented Generation)と呼ばれる技術を用いれば、社内のファイルサーバーに保管されている仕様書や過去の議事録をLLMがリアルタイムで参照し、最新かつ正確な情報に基づいた回答を生成できます。この連携はすべて社内LANで行われるため、外部へのデータ漏洩リスクは極めて低く、高速なレスポンスが期待できます。さらに、Active Directoryなどの既存の認証基盤と組み合わせることで、役職や所属部門に応じた厳密なアクセス制御を維持したまま、セキュアなAI活用を実現できるのです。
日本語対応の現状と企業利用における評価ポイント
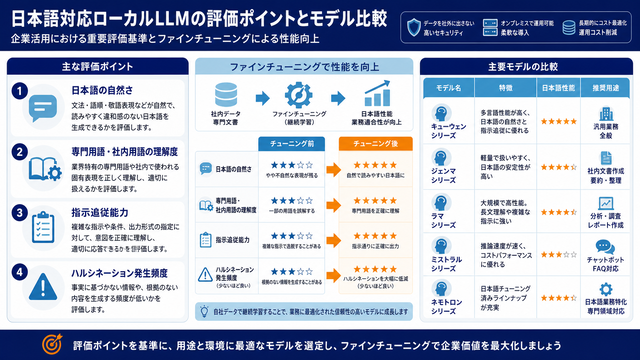
ローカルLLMの日本語対応は急速に進展していますが、企業が利用する際は、専門用語への対応力や文脈理解の精度を実データで検証することが不可欠です。多くのオープンソースモデルは英語を中心に学習されているため、日本語の流暢さや正確性にはばらつきがあります。
特に、日本語特有の曖昧な表現や、業界ごとに異なる専門用語を正しく理解し、文脈に沿った適切な回答を生成できるかどうかは、業務利用における実用性を左右する重要な評価軸となります。
企業が導入を検討する際に評価すべき具体的な基準としては、「日本語の自然さ」「専門用語・社内用語の理解度」「指示追従能力」「ハルシネーション(事実に基づかない情報の生成)の発生頻度」などが挙げられます。これらの性能は、公開されているベンチマークスコアだけでは判断が難しいため、自社のドキュメントや過去の問い合わせデータなどを用いて実際にテストし、業務要件を満たす日本語性能を持つモデルを選定するプロセスが極めて重要です。
企業向けローカルLLMの日本語性能評価ポイント
| 評価項目 | 詳細 | 評価の重要性 |
|---|---|---|
| 日本語の自然さ | 不自然な言い回しや誤字脱字がなく、人間が書いたような自然な日本語を生成できるか。 | ユーザー体験に直結し、業務での受容性を高める。 |
| 専門用語・社内用語の理解度 | 業界固有の専門用語や、企業内で使われる略語・固有名詞を正確に理解し、適切に利用できるか。 | 業務効率化の核となり、誤解や誤情報のリスクを低減する。 |
| 指示追従能力 | 複雑な指示や複数の条件を含むプロンプトに対し、意図通りに正確な回答を生成できるか。 | 高度な業務支援や自動化を実現するために不可欠。 |
| 文脈理解の精度 | 長文や複数のやり取りの中で、全体の文脈を正確に把握し、一貫性のある回答を生成できるか。 | 複雑な問い合わせ対応や文書作成において、質の高いアウトプットを保証する。 |
| ハルシネーションの発生頻度 | 事実に基づかない情報や、もっともらしいが誤った情報を生成する頻度。 | 信頼性に関わる最重要項目。誤情報による損害リスクを避ける。 |
最新モデルの日本語性能とチューニングの可能性
最新のオープンソースモデルは高い日本語性能を備えていますが、企業の独自データでファインチューニングを施すことで、業務特化型の高精度なAIを実現できます。汎用的なモデルでも基本的な日本語の扱いは可能ですが、企業の競争力の源泉となる独自のナレッジや業務フローに最適化するためには、カスタマイズが欠かせません。
このチューニングにより、社内用語を正確に理解し、自社の文脈に即した回答を生成する、真に「使える」AIアシスタントを育成することが可能になります。
現在、企業での利用を想定した日本語対応ローカルLLMとして、いくつかの有力な選択肢が存在します。以下に代表的なモデルを挙げ、その特徴を比較します。
| モデルシリーズ | 開発元 | 主な特徴 | ライセンス |
|---|---|---|---|
| Alibaba | 高い日本語性能を持ち、多様なモデルサイズが提供されている。商用利用も可能で、多くの日本企業で採用検討が進んでいる。 | Tongyi Qianwen LICENSE AGREEMENT (商用利用可) | |
| Googleが開発した軽量かつ高性能なモデル。研究・商用利用が可能で、ローカル環境での高速な推論に適している。 | Gemma Terms of Use (商用利用可) | ||
| Meta | オープンソースLLMの代表格。巨大な開発者コミュニティが存在し、日本語化された派生モデルも多数公開されている。 | Llama 3 Community License Agreement (商用利用可) | |
| Mistral AI | 高性能かつ効率的なモデルで、特に軽量版は限られたリソースでも動作しやすい。バランスの取れた性能で人気が高い。 | Apache 2.0 (商用利用可) ※一部非商用ライセンス | |
| NVIDIA | NVIDIAのGPUに最適化されており、高いパフォーマンスが期待できる。企業向けソリューションとしての側面が強く、日本語対応も強化されている。 | NVIDIA Open Model License (商用利用可) |
これらのモデルをベースに、自社のデータを用いてファインチューニングやLoRA(Low-Rank Adaptation)といった手法で追加学習を行うことで、汎用モデルでは対応できないニッチな業務知識をAIに組み込むことが可能です。
どのモデルが自社に最適かを見極める「ローカルLLMモデル比較」は、導入成功の第一歩と言えるでしょう。
セキュリティとガバナンス強化:ローカルLLMがもたらす最大の利点
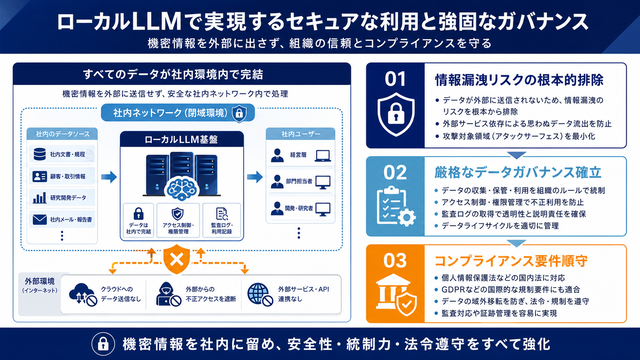
ローカルLLMがもたらす最大の利点は、機密情報を外部に送信することなく社内環境で完結して処理できるため、情報漏洩リスクを根本的に排除し、厳格なデータガバナンスを確立できる点です。
クラウドベースの生成AIサービスを利用する場合、入力したデータがどのように扱われるか、学習に利用されないか、どの国のデータセンターに保管されるかといった懸念が常につきまといます。サービス提供者のセキュリティポリシーに依存せざるを得ず、自社で完全にコントロールすることは困難です。
これに対し、ローカルLLMは自社のデータセンターやプライベートクラウドといった、物理的にも論理的にも管理下にある環境で運用されます。これにより、データが企業の管理境界を越えることがないため、外部への情報漏洩リスクを大幅に低減できます。
情報システム部門は、データのライフサイクル全体(生成、保存、利用、転送、破棄)にわたって自社のセキュリティポリシーを適用し、監査証跡を確実に取得できるため、最高レベルのデータガバナンスを維持したままAIの恩恵を享受できます。
データ漏洩リスクの最小化とコンプライアンス遵守
ローカルLLMは、データを物理的・論理的に社内ネットワーク内に留めることで、外部からの不正アクセスや意図しない情報流出の可能性を最小化し、コンプライアンス要件の遵守に寄与します。
すべてのデータ処理が閉域網内で完結するため、インターネットからのサイバー攻撃に対する攻撃対象領域(アタックサーフェス)を大幅に縮小できます。これにより、外部への情報漏洩という、企業にとって最も避けたいインシデントの発生確率を大幅に低減することが可能です。
また、金融業界におけるFISC安全対策基準、医療業界の3省2ガイドライン、あるいは個人情報保護法やGDPRなど、特定の業界や地域で課せられる厳しいデータ管理・コンプライアンス要件への対応も容易になります。
データが国外のサーバーに移転される心配がないため、データ越境に関する法規制に対応できます。さらに、既存のアクセス管理システムやログ監視ソリューションと連携させることで、誰が・いつ・どのデータを使ってAIを利用したかを正確に記録・追跡し、内部統制や監査要求にも万全の体制で応えることができるのです。
ローカルLLM導入のメリット・デメリットと戦略的判断基準
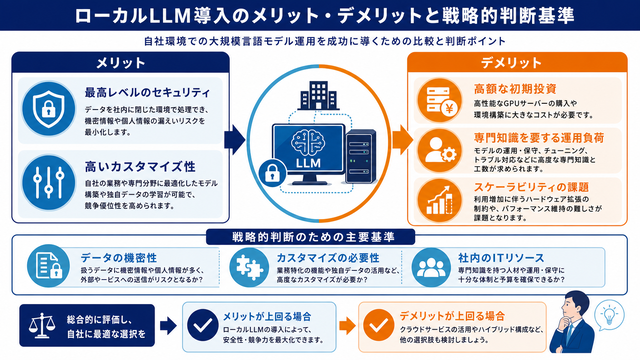
ローカルLLM導入の判断は、セキュリティ強化という絶大なメリットと、高度な専門知識を要する運用負荷や初期コストというデメリットを天秤にかけ、自社のITリソースとデータ戦略に基づいて戦略的に行う必要があります。セキュリティとカスタマイズ性を最高レベルで両立できる点は大きな魅力ですが、その実現には相応の投資と体制が求められます。したがって、導入を検討する情報システム部門は、技術的な側面だけでなく、経営的な視点からその是非を慎重に判断しなければなりません。
具体的な戦略的判断基準としては、まず「扱うデータの機密性」が挙げられます。研究開発データや個人情報など、漏洩時の影響が甚大な情報を扱う場合は、ローカルLLMの導入価値は非常に高くなります。次に「求めるカスタマイズの度合い」です。
自社特有の業務プロセスに深く組み込む必要がある場合、自由にチューニングできるローカルLLMが適しています。そして、「社内の技術力と予算」を現実的に評価し、自社で運用を完結できるか、あるいは外部パートナーの支援が必要かを見極めることが重要です。
【関連記事】社内ネットワークの仕組みとは?基本構成や構築手順、ポイントを解説
費用対効果と運用負荷:既存インフラとの統合性
ローカルLLMの費用対効果は、高性能なGPUサーバーへの初期投資と専門人材による運用コストを、情報漏洩リスクの低減や業務効率化によるリターンが上回るかで評価されます。
初期投資としては、NVIDIA社のA100やH100といったAI処理に特化したGPUを搭載したサーバーの購入またはリース費用が大きな割合を占めます。これらのハードウェアは数百万円から数千万円に及ぶこともあり、計画的な予算確保が必要です。ローカルLLMのスペックを追求するほど、このコストは増大します。
また、運用フェーズでは、サーバーの消費電力や冷却コストといったランニングコストに加え、モデルの継続的なアップデート、セキュリティパッチの適用、性能監視などを行う専門エンジニアの人件費が発生します。
この運用負荷を軽減するため、VMwareなどの既存の仮想化基盤や、Kubernetesといったコンテナオーケストレーションツールと統合し、インフラ管理を効率化するアプローチが有効です。クラウドサービスの利用料という変動費が、ハードウェア資産と人件費という固定費に置き換わる点を理解し、長期的な視点で費用対効果を算出することが求められます。
性能要件とスケーラビリティの課題
ローカルLLMの性能は搭載するGPUのVRAM容量と演算能力に大きく依存し、将来の利用者増に対応するためのスケーラビリティ確保が重要な課題となります。高性能なLLM、特にパラメータ数が数十億から数百億に達するモデルを快適に動作させるには、1台のサーバーに数十GBから数百GBもの大容量VRAMが必要となる場合があります。
この要件を満たすハードウェアを選定することが、実用的な応答速度を確保する上での大前提です。
導入当初は利用者が少なくても、その利便性が認知されるにつれて利用部門やユースケースが拡大し、システムへの負荷が増大することが予想されます。クラウドサービスのようにオンデマンドでリソースを拡張することが難しいため、将来的な需要増を見越したインフラ設計が不可欠です。
複数のGPUサーバーを連携させて負荷を分散させるクラスタ構成や、利用頻度に応じてリソースを動的に割り当てる仕組みなど、スケーラビリティを確保するためのアーキテクチャを初期段階から検討しておくことが、持続可能なAI基盤を構築する鍵となります。
企業におけるローカルLLMの具体的な導入ロードマップと活用事例
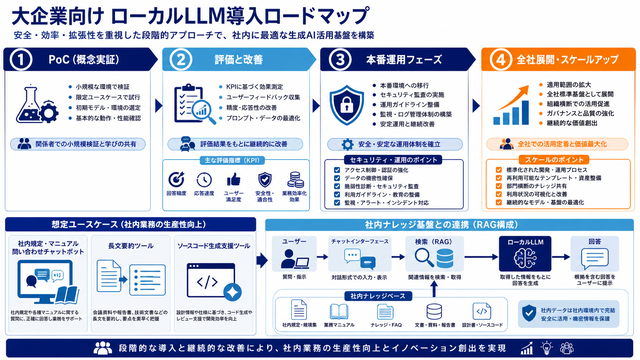
企業におけるローカルLLMの導入は、限定的な部門でのPoC(概念実証)から始め、効果を検証しながら段階的に全社展開へとスケールさせていくロードマップが現実的です。最初から大規模な全社導入を目指すのは、リスクとコストの両面でハードルが高くなります。
まずは特定の業務課題を解決する小規模なプロジェクトとしてスタートし、成功体験を積み重ねながら社内の理解と協力を得ていくアプローチが成功の確率を高めます。
具体的な活用事例としては、「社内規定や業務マニュアルに関する問い合わせ対応チャットボット」が挙げられます。
これは、人事部や情報システム部門への定型的な問い合わせを自動化し、担当者の負荷を軽減するものです。その他にも、「長文の議事録や技術報告書を数行に要約するツール」や、「プログラマーの開発効率を高めるためのソースコード生成支援ツール」など、さまざまな部門で業務効率を向上させるユースケースが考えられます。これらの具体的な目標を設定することが、導入プロジェクトを推進する上での第一歩となります。
PoC(概念実証)から本番運用へのステップ
PoCから本番運用へ移行する鍵は、明確な評価指標(KPI)を設定し、利用部門からのフィードバックを基に継続的な改善サイクルを回すことです。PoCの段階では、「問い合わせ対応工数の削減率」や「ドキュメント検索時間の短縮率」、「ユーザー満足度スコア」といった定量的・定性的なKPIを事前に定めます。
そして、対象業務を絞り込み、少人数のパイロットユーザーに実際に利用してもらい、その効果をKPIに基づいて客観的に評価します。
PoCで有効性が確認できたら、次はいよいよ本番運用への移行です。このステップでは、より広範なユーザーが利用することに備え、セキュリティ監査の実施、安定稼働を維持するための運用監視体制の構築、そして全社的な利用ルールを定めたガイドラインの策定が不可欠となります。PoCで得られた知見やユーザーからの改善要望を反映させながら、システムをブラッシュアップし、徐々に利用範囲を拡大していく。この地道なプロセスが、ローカルLLMを企業文化に根付かせるための王道と言えるでしょう。
日本語特化モデルの選定と社内ナレッジベース構築
社内ナレッジベースを構築する際は、日本語の扱いに長けたモデルを選定し、RAG技術を用いて既存のドキュメント管理システムと連携させるアプローチが最も効果的です。数あるローカルLLMモデルの中から、特に日本語の言語構造や文化的背景を深く理解しているモデル、例えばQwenシリーズのように日本語性能を強みとするモデルを選ぶことが、ユーザーにとって自然で違和感のない対話体験を実現する上で重要です。
モデル選定と並行して、社内に散在するナレッジをAIが参照できる形に整備します。具体的には、SharePointやConfluence、社内ファイルサーバーなどに保管されているドキュメントを、Vector DB(ベクトルデータベース)と呼ばれる特殊なデータベースに格納します。
ユーザーから質問が入力されると、システムはまずVector DBの中から関連性の高い情報を検索し、その情報を基にLLMが回答を生成します。このRAGアーキテクチャにより、LLMが学習していない社内の最新情報や独自ノウハウについても、正確に回答することが可能になるのです。
まとめ:ローカルLLMが拓く情報システム部門の未来とDX推進
ローカルLLMは、単なる技術導入に留まらず、情報システム部門がデータセキュリティの守護者からDX推進の主導者へと役割を変革させ、企業の競争力を根幹から支える戦略的基盤となります。これまで情報漏洩のリスクを恐れて活用が難しかった機密性の高い社内データを、安全な環境でAIに追加学習させ、新たな知見を引き出すことを可能にします。
これにより、情報システム部門は、インフラを安定稼働させるという従来の守りの役割に加え、ビジネス部門と密に連携し、AIを活用した新たな業務価値を創出する攻めの役割を担うことができるようになります。
日本語対応可能なローカルLLMの登場は、日本の企業にとって、自社の貴重なデータ資産を最大限に活用し、グローバルな競争を勝ち抜くための強力な武器となり得ます。
導入にはハードウェア投資や専門人材の育成といった課題も伴いますが、PoCから着実にステップを踏むことで、その恩恵を享受することは十分に可能です。情報システム部門が主導してセキュアなAI活用環境を全社に提供すること、それこそが、企業のデジタルトランスフォーメーションを真に加速させ、持続的な成長を実現する鍵となるでしょう。
ローカルLLMの導入や社内AIの活用を検討している方は、選択肢の一つとしてTDCソフトの「Nenoa」もご覧ください。